简介
在这篇附加章节里,我们来看看计算着色器。 到目前为止,前面各章处理的都是 Vulkan 管线中传统的图形部分。 但与 OpenGL 这类更早的 API 不同,Vulkan 对计算着色器的支持是强制的。 这意味着,无论运行在哪一种 Vulkan 实现上,你都能使用计算着色器——不管它是高端桌面 GPU 还是低功耗嵌入式设备。
这为在图形处理器(GPU)上进行通用计算(general purpose computing on graphics processor units,GPGPU)打开了大门,无论你的应用运行在哪里。 GPGPU 意味着你可以在 GPU 上完成通用计算,而这向来是 CPU 的领域。 但随着 GPU 越来越强大、越来越灵活,许多原本需要 CPU 通用能力的工作负载,现在都能在 GPU 上实时完成。
GPU 计算能力可用于的典型场景包括图像处理、可见性测试、后期处理、高级光照计算、动画、物理(例如粒子系统)等等。 甚至还能把计算用于不产生任何图形输出的纯计算工作,例如数值运算或与 AI 相关的任务。 这被称为“无头计算”(headless compute)。
优势
在 GPU 上做计算量大的运算有若干好处。 最明显的一点是把工作从 CPU 卸载出去。 另一点是不必在 CPU 主存与 GPU 内存之间搬运数据。 所有数据都可以留在 GPU 上,不必等待从主存缓慢传输过来。
除此之外,GPU 的并行度极高,其中一些拥有数万个小型计算单元。 因此对高度并行的工作流来说,GPU 往往比只有少数大型计算单元的 CPU 更合适。
Vulkan 管线
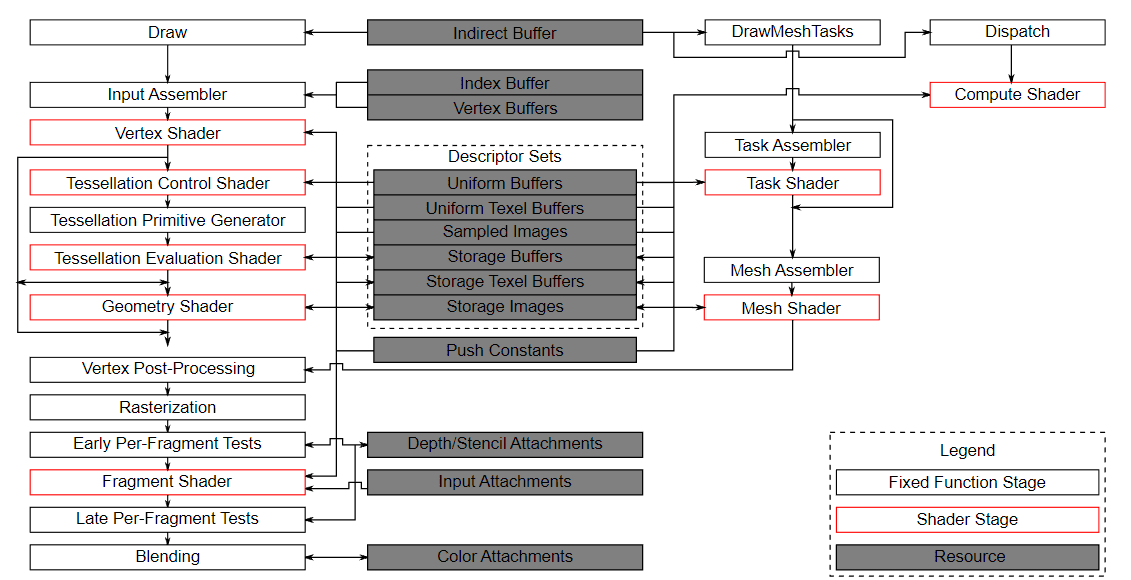
需要知道的是,计算与管线的图形部分完全分离。 官方规范中的下面这张 Vulkan 管线框图就体现了这一点:
在这张图里,左侧是管线中传统的图形部分,右侧则是若干并不属于这条图形管线的阶段,其中就包括计算着色器(阶段)。 由于计算着色器阶段脱离了图形管线,我们可以把它用在任何认为合适的地方。 这与片元着色器之类的情况差别很大——片元着色器总是作用于顶点着色器变换后的输出。
图中央还表明,描述符集等对象同样会被计算使用,所以我们学过的关于描述符布局、描述符集和描述符的一切在这里依然适用。
一个示例
本章要实现一个容易理解的例子:基于 GPU 的粒子系统。 这类系统被用在许多游戏中,通常包含成千上万个粒子,且必须在可交互的帧率下更新。 渲染这样的系统需要两个主要部分:以顶点缓冲区传入的顶点,以及某种按公式更新它们的方法。
“经典”的、基于 CPU 的粒子系统会把粒子数据存放在系统主存里,然后用 CPU 更新它们。 更新完成后,顶点又得重新传输到 GPU 内存,这样下一帧才能显示更新后的粒子。 最直白的做法是每帧都用新数据重建顶点缓冲区。 这种做法的开销非常大。 具体取决于你的实现,还有其他选择,例如映射 GPU 内存以便 CPU 写入(在桌面系统上称为“可调整大小的 BAR”,在集成 GPU 上则是统一内存),或者直接使用主机本地缓冲区(由于受 PCI-E 带宽限制,这是最慢的方式)。 但无论你选择哪种缓冲区更新方式,更新粒子总归要往 CPU 走一趟“往返”。
而基于 GPU 的粒子系统不再需要这趟往返。 顶点只在开始时上传到 GPU,之后所有更新都在 GPU 内存中由计算着色器完成。 这样做更快的主要原因之一,是 GPU 与其本地内存之间的带宽高得多。 在基于 CPU 的方案里,你会受限于主存和 PCI-express 带宽,那通常只是 GPU 内存带宽的一小部分。
如果在带专用计算队列的 GPU 上这么做,你还可以让粒子的更新与图形管线的渲染部分并行进行。 这被称为“异步计算”,属于本教程不涉及的高级话题。
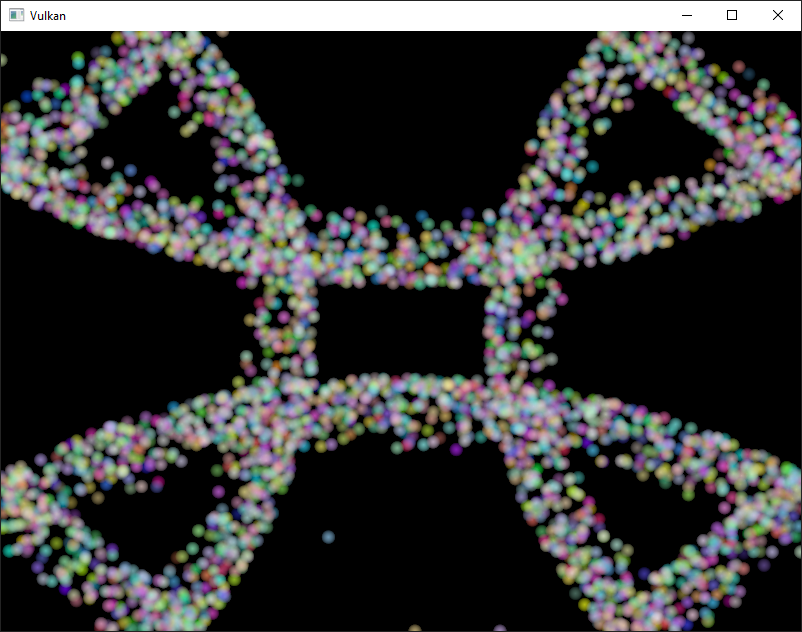
下面是本章代码运行时的截图。 这里显示的粒子由计算着色器直接在 GPU 上更新,不涉及任何 CPU 交互:
数据操作
在本教程中,我们已经了解了不同类型的缓冲区,例如用来传入图元的顶点缓冲区和索引缓冲区,以及用来向着色器传数据的统一缓冲区。 我们也用过图像来做纹理映射。 但到目前为止,数据总是由 CPU 写入,GPU 只负责读取。
计算着色器引入的一个重要概念,是能够任意地读取和写入缓冲区。 为此,Vulkan 提供了两种专门的存储类型。
着色器存储缓冲区对象(SSBO)
着色器存储缓冲区(shader storage buffer,SSBO)允许着色器读写缓冲区。 它的用法与统一缓冲区对象类似。 最大的区别在于:你可以把其他类型的缓冲区也当作 SSBO 使用(alias),并且 SSBO 可以任意大。
回到基于 GPU 的粒子系统,你现在可能会问:顶点既要由计算着色器更新(写入),又要由顶点着色器读取(绘制),这该怎么办?毕竟这两种用途看起来需要不同的缓冲区类型。
但事实并非如此。 在 Vulkan 中,你可以为缓冲区和图像指定多种用途。 所以要让粒子顶点缓冲区既作为顶点缓冲区(在图形阶段)使用,又作为存储缓冲区(在计算阶段)使用,只需在创建时带上这两个用途标志:
vk::BufferCreateInfo bufferInfo{};
...
bufferInfo.usage = vk::BufferUsageFlagBits::eVertexBuffer | vk::BufferUsageFlagBits::eStorageBuffer | vk::BufferUsageFlagBits::eTransferDst;
...

shaderStorageBuffers[i] = vk::raii::Buffer(*device, bufferInfo);
通过 bufferInfo.usage 设置的 vk::BufferUsageFlagBits::eVertexBuffer 和 vk::BufferUsageFlagBits::eStorageBuffer 这两个标志告诉实现:我们希望把这个缓冲区用于两种不同场景——在顶点着色器中作为顶点缓冲区,以及作为存储缓冲区。
注意我们还加上了 vk::BufferUsageFlagBits::eTransferDst 标志,这样才能把数据从主机传输到 GPU。
这一点至关重要:我们希望着色器存储缓冲区只留在 GPU 内存中(vk::MemoryPropertyFlagBits::eDeviceLocal),因此必须先把这个缓冲区的数据从主机传过去。
下面是使用 createBuffer 辅助函数的同一段代码:
vk::raii::Buffer shaderStorageBufferTemp({});
vk::raii::DeviceMemory shaderStorageBufferTempMemory({});
createBuffer(bufferSize, vk::BufferUsageFlagBits::eStorageBuffer | vk::BufferUsageFlagBits::eVertexBuffer | vk::BufferUsageFlagBits::eTransferDst, vk::MemoryPropertyFlagBits::eDeviceLocal, shaderStorageBufferTemp, shaderStorageBufferTempMemory);
copyBuffer(stagingBuffer, shaderStorageBufferTemp, bufferSize);
shaderStorageBuffers.emplace_back(std::move(shaderStorageBufferTemp));
shaderStorageBuffersMemory.emplace_back(std::move(shaderStorageBufferTempMemory));
在 Slang 中访问这类缓冲区的声明如下:
struct Particle {
	float2 position;
	float2 velocity;
    float4 color;
};

struct ParticleSSBO {
    Particle particles;
};
StructuredBuffer<ParticleSSBO> particlesIn;
RWStructuredBuffer<ParticleSSBO> particlesOut;
在这个示例里,我们有一个带类型的 SSBO,每个粒子都有一个位置值和一个速度值(见 Particle 结构体)。
由于它被放进没有上限的 StructuredBuffer,这个 SSBO 可以容纳任意数量的粒子;对 particlesIn 来说它是只读缓冲区,而 particlesOut 则被放进 RWStructedBuffer。
不必指定 SSBO 中的元素数量,这是它相对于统一缓冲区等方案的优势之一。
在计算着色器中写入这样的存储缓冲区对象很直接,写法与你在 C++ 侧写缓冲区类似:
particlesOut[index].particles.position = particlesIn[index].particles.position + particlesIn[index].particles.velocity.xy * ubo.deltaTime;存储图像
注意,本章不会做图像处理。 这一段放在这里,只是为了让读者知道计算着色器同样可以用于图像处理。
存储图像允许你读写图像。 典型用途包括给纹理施加图像效果、做后期处理(其实非常类似),或者生成 mipmap。
图像这边也是类似的:
vk::ImageCreateInfo imageInfo {};
...
imageInfo.usage = vk::ImageUsageFlagBits::eSampled | vk::ImageUsageFlagBits::eStorage;
...

textureImage = std::make_unique<vk::raii::SwapchainKHR>( *device, swapChainCreateInfo );
通过 imageInfo.usage 设置的 vk::ImageUsageFlagBits::eSampled 和 vk::ImageUsageFlagBits::eStorage 这两个标志告诉实现:我们希望把这张图像用于两种不同场景——在片元着色器中作为被采样的图像,以及在计算着色器中作为存储图像。
存储图像在 Slang 中的声明与采样的图像类似,比如片元着色器里用的那种:
[vk::image_format("r32f")] Texture2D<float> inputImage;
[vk::image_format("r32f")] RWTexture2D<float> outputImage;
这里有几处不同:增加了像 r32f 这样指定图像格式的属性,以及只读的 Texture2D 与读写的 RWTexture2D 这两种写法。
最后同样重要的是,声明存储图像必须使用 RWTexture2D 类型。
在计算着色器中读写存储图像,则使用数组下标语法:
float3 pixel = inputImage[int2(gl_GlobalInvocationID.xy)].rgb;
outputImage[int2(gl_GlobalInvocationID.xy)] = pixel;
计算队列族
在 物理设备与队列族那一章里,我们已经了解了队列族,以及如何挑选图形队列族。
计算使用队列族属性标志位 vk::QueueFlagBits::eCompute。
所以若要提交计算工作,我们需要从支持计算的队列族中取一个队列。
注意,Vulkan 要求支持图形操作的实现至少有一个同时支持图形与计算操作的队列族,但实现也可以提供专用的计算队列。 这种专用计算队列(不带图形位)暗示着一条异步计算队列。 不过为了保持本教程对初学者友好,我们会使用既能做图形又能做计算的队列。 这样也省得去处理若干高级同步机制。
对计算示例来说,我们需要稍微改动设备创建部分的代码:
std::vector<vk::QueueFamilyProperties> queueFamilyProperties = physicalDevice->getQueueFamilyProperties();

// get the first index into queueFamilyProperties which supports graphics and compute
auto graphicsAndComputeQueueFamilyProperty =
  std::find_if( queueFamilyProperties.begin(),
                queueFamilyProperties.end(),
                []( vk::QueueFamilyProperties const & qfp ) { return (qfp.queueFlags & vk::QueueFlagBits::eGraphics && qfp.queueFlags & vk::QueueFlagBits::eCompute); } );
graphicsAndComputeIndex = static_cast<uint32_t>( std::distance( queueFamilyProperties.begin(), graphicsAndComputeQueueFamilyProperty ) );
改动后的队列族索引选择代码现在会去找同时支持图形与计算的队列族。
之后就可以在 createLogicalDevice 中从这个队列族取一个计算队列:
computeQueue = std::make_unique<vk::raii::Queue>( *device, graphicsAndComputeIndex, 0 );计算着色器阶段
在图形示例中,我们用过不同的管线阶段来加载着色器、访问描述符。
计算着色器的访问方式类似,使用 vk::ShaderStageFlagBits::eCompute 管线阶段。
所以加载计算着色器与加载顶点着色器完全相同,只是着色器阶段不同。
接下来几段会详细讨论这一点。
计算还为描述符和管线引入了新的绑定点类型 vk::PipelineBindPoint::eCompute,后面我们会用到它。
加载计算着色器
在应用里加载计算着色器,与加载其他任何着色器一样。
唯一实质性的区别是,我们需要用到前面提到的 vk::ShaderStageFlagBits::eCompute。
auto computeShaderCode = readFile("shaders/slang.spv");

vk::PipelineShaderStageCreateInfo computeShaderStageInfo({}, vk::ShaderStageFlagBits::eCompute, shaderModule, "compMain");
...
准备着色器存储缓冲区
前面我们了解到,可以用着色器存储缓冲区把任意数据传给计算着色器。 在这个例子里,我们会把一组粒子上传到 GPU,这样就可以直接在 GPU 内存中操作它们。
在 在途帧那一章,我们讲过按在途帧复制资源,好让 CPU 和 GPU 都保持忙碌。 首先,我们为缓冲区对象和支撑它的设备内存各声明一个向量:
std::vector<vk::raii::Buffer> shaderStorageBuffers;
std::vector<vk::raii::DeviceMemory> shaderStorageBuffersMemory;
接着在 createShaderStorageBuffers 函数里清空这两个向量,以清理其中已经创建的对象——这也是我们使用 RAII 的一贯做法。
shaderStorageBuffers.clear();
shaderStorageBuffersMemory.clear();
有了这套准备,就可以开始把初始的粒子信息搬到 GPU 上了。 我们先在主机侧初始化一组粒子:
// Initialize particles
std::default_random_engine rndEngine((unsigned)time(nullptr));
std::uniform_real_distribution<float> rndDist(0.0f, 1.0f);

// Initial particle positions on a circle
std::vector<Particle> particles(PARTICLE_COUNT);
for (auto& particle : particles) {
    float r = 0.25f * sqrtf(rndDist(rndEngine));
    float theta = rndDist(rndEngine) * 2.0f * 3.14159265358979323846f;
    float x = r * cosf(theta) * HEIGHT / WIDTH;
    float y = r * sinf(theta);
    particle.position = glm::vec2(x, y);
    particle.velocity = normalize(glm::vec2(x,y)) * 0.00025f;
    particle.color = glm::vec4(rndDist(rndEngine), rndDist(rndEngine), rndDist(rndEngine), 1.0f);
}
然后我们在主机内存里创建一个 暂存缓冲区,用来存放初始的粒子属性:
    vk::DeviceSize bufferSize = sizeof(Particle) * PARTICLE_COUNT;

    // Create a staging buffer used to upload data to the gpu
    vk::raii::Buffer stagingBuffer({});
    vk::raii::DeviceMemory stagingBufferMemory({});
    createBuffer(bufferSize, vk::BufferUsageFlagBits::eTransferSrc, vk::MemoryPropertyFlagBits::eHostVisible | vk::MemoryPropertyFlagBits::eHostCoherent, stagingBuffer, stagingBufferMemory);

    void* dataStaging = stagingBufferMemory.mapMemory(0, bufferSize);
    memcpy(dataStaging, particles.data(), (size_t)bufferSize);
    stagingBufferMemory.unmapMemory();
以这个暂存缓冲区为源,我们随后创建每帧各自的着色器存储缓冲区,并把粒子属性从暂存缓冲区复制到每一个里面:
    // Copy initial particle data to all storage buffers
    for (size_t i = 0; i < MAX_FRAMES_IN_FLIGHT; i++) {
        vk::raii::Buffer shaderStorageBufferTemp({});
        vk::raii::DeviceMemory shaderStorageBufferTempMemory({});
        createBuffer(bufferSize, vk::BufferUsageFlagBits::eStorageBuffer | vk::BufferUsageFlagBits::eVertexBuffer | vk::BufferUsageFlagBits::eTransferDst, vk::MemoryPropertyFlagBits::eDeviceLocal, shaderStorageBufferTemp, shaderStorageBufferTempMemory);
        copyBuffer(stagingBuffer, shaderStorageBufferTemp, bufferSize);
        shaderStorageBuffers.emplace_back(std::move(shaderStorageBufferTemp));
        shaderStorageBuffersMemory.emplace_back(std::move(shaderStorageBufferTempMemory));
    }
}
描述符
为计算设置描述符与图形几乎完全相同。
唯一的区别是,描述符需要设置 vk::ShaderStageFlagBits::eCompute,以便计算阶段能够访问它们:
 std::array layoutBindings{
            vk::DescriptorSetLayoutBinding(0, vk::DescriptorType::eUniformBuffer, 1, vk::ShaderStageFlagBits::eCompute, nullptr),
 };
...
注意这里可以把多个着色器阶段组合起来。例如某个统一缓冲区里的参数会被顶点阶段和计算阶段共用,而你希望描述符在这两个阶段都能访问,那就把两个阶段的位都设上:
layoutBindings[0].stageFlags = vk::ShaderStageFlagBits::eVertex | vk::ShaderStageFlagBits::eCompute;下面是我们这个示例的描述符设置。 布局长这样:
std::array layoutBindings{
    vk::DescriptorSetLayoutBinding(0, vk::DescriptorType::eUniformBuffer, 1, vk::ShaderStageFlagBits::eCompute, nullptr),
    vk::DescriptorSetLayoutBinding(1, vk::DescriptorType::eStorageBuffer, 1, vk::ShaderStageFlagBits::eCompute, nullptr),
    vk::DescriptorSetLayoutBinding(2, vk::DescriptorType::eStorageBuffer, 1, vk::ShaderStageFlagBits::eCompute, nullptr)
};

vk::DescriptorSetLayoutCreateInfo layoutInfo({}, layoutBindings.size(), layoutBindings.data());
computeDescriptorSetLayout = std::make_unique<vk::raii::DescriptorSetLayout>( *device, layoutInfo );
看到这套设置,你可能会奇怪:明明只渲染一个粒子系统,为什么会有两个针对着色器存储缓冲区对象的布局绑定? 这是因为粒子位置是按帧、依据时间增量更新的。 也就是说,每一帧都需要知道上一帧的粒子位置,才能用新的时间增量更新它们,并写入属于自己这帧的 SSBO:

为此,计算着色器需要能同时访问上一帧和当前帧的 SSBO。
办法就是在描述符设置里把两者都传给计算着色器。
参见 storageBufferInfoLastFrame 和 storageBufferInfoCurrentFrame:
for (size_t i = 0; i < MAX_FRAMES_IN_FLIGHT; i++) {
    vk::DescriptorBufferInfo bufferInfo(uniformBuffers[i], 0, sizeof(UniformBufferObject));

    vk::DescriptorBufferInfo storageBufferInfoLastFrame(shaderStorageBuffers[(i - 1) % MAX_FRAMES_IN_FLIGHT], 0, sizeof(Particle) * PARTICLE_COUNT);
    vk::DescriptorBufferInfo storageBufferInfoCurrentFrame(shaderStorageBuffers[i], 0, sizeof(Particle) * PARTICLE_COUNT);
    std::array descriptorWrites{
        vk::WriteDescriptorSet( computeDescriptorSets[i], 0, 0, 1, vk::DescriptorType::eUniformBuffer, nullptr, &bufferInfo ),
        vk::WriteDescriptorSet( computeDescriptorSets[i], 1, 0, 1, vk::DescriptorType::eStorageBuffer, nullptr, &storageBufferInfoLastFrame),
        vk::WriteDescriptorSet( computeDescriptorSets[i], 2, 0, 1, vk::DescriptorType::eStorageBuffer, nullptr, &storageBufferInfoCurrentFrame),
    };
    device->updateDescriptorSets(descriptorWrites, {});
}
记住,我们还得在描述符池里申请这些 SSBO 对应的描述符类型:
std::array poolSize {
    vk::DescriptorPoolSize( vk::DescriptorType::eUniformBuffer, MAX_FRAMES_IN_FLIGHT),
    vk::DescriptorPoolSize(  vk::DescriptorType::eStorageBuffer, MAX_FRAMES_IN_FLIGHT * 2)
};
从池中申请的 vk::DescriptorType::eStorageBuffer 数量需要翻倍,因为我们的描述符集同时引用了上一帧和当前帧的 SSBO。
计算管线
由于计算并不是图形管线的一部分,我们不能用 device→createGraphicsPipeline。
我们需要改用 device→createComputePipeline 创建专用的计算管线来执行计算命令。
由于计算管线不涉及任何光栅化状态,它的状态比图形管线少得多:
vk::PipelineLayoutCreateInfo pipelineLayoutInfo({}, 1, &**computeDescriptorSetLayout);

computePipelineLayout = std::make_unique<vk::raii::PipelineLayout>( *device, pipelineLayoutInfo );
设置过程简单得多,因为我们只需要一个着色器阶段和一个管线布局。 管线布局的用法与图形管线相同:
vk::ComputePipelineCreateInfo pipelineInfo({}, computeShaderStageInfo, *computePipelineLayout);
computePipeline = std::make_unique<vk::raii::Pipeline>(device->createComputePipeline( nullptr, pipelineInfo));
计算空间
在深入讲计算着色器如何工作、如何把计算工作负载提交给 GPU 之前,需要先弄清两个重要的计算概念:工作组(work group)与调用(invocation)。 它们定义了一套抽象的执行模型,描述 GPU 的计算硬件如何按三个维度(x、y、z)处理计算工作负载。
工作组描述计算工作负载如何组成、又如何被 GPU 的计算硬件处理。 你可以把它想成 GPU 需要逐一处理的工作项。 工作组的维度由应用在记录命令缓冲区时通过调度命令设置。
而每个工作组又由一组调用构成,这些调用执行同一个计算着色器。 调用可能并行运行,其维度在计算着色器中设置。 同一个工作组内的调用可以访问共享内存。
下图展示了二者在三个维度上的关系:

工作组(由 computeCommandBuffers[frameIndex]→dispatch 定义)与调用(由计算着色器中的局部尺寸定义)各自的维度数量,取决于输入数据的组织方式。
例如你处理的是一维数组——就像本章这样——那么两者都只需要指定 x 维度。
举个例子:如果调度的组数为 [64, 1, 1],而计算着色器的局部尺寸为 [32, 32, 1],那么这个计算着色器会被调用 64 x 32 x 32 = 65,536 次。
注意,工作组数量和局部尺寸的上限因实现而异,所以你应当始终检查 vk::PhysicalDeviceLimits 中与计算相关的 maxComputeWorkGroupCount、maxComputeWorkGroupInvocations 和 maxComputeWorkGroupSize 限制。
计算着色器
现在我们已经了解了搭起一条计算着色器管线所需的各个部分,是时候看看计算着色器本身了。 我们学过的 GLSL 着色器用法——比如顶点着色器和片元着色器——同样适用于计算着色器。 语法相同,许多概念也相同,例如在应用与着色器之间传递数据。 但也有一些重要差异。
一个非常基础、用于更新线性粒子数组的计算着色器可能长这样:
struct Particle {
	float2 position;
	float2 velocity;
    float4 color;
};

struct UniformBuffer {
    float deltaTime;
};
ConstantBuffer<UniformBuffer> ubo;

struct ParticleSSBO {
    Particle particles;
};
StructuredBuffer<ParticleSSBO> particlesIn;
RWStructuredBuffer<ParticleSSBO> particlesOut;


[shader("compute")]
[numthreads(256,1,1)]
void compMain(uint3 threadId : SV_DispatchThreadID)
{
    uint index = threadId.x;

    particlesOut[index].particles.position = particlesIn[index].particles.position + particlesIn[index].particles.velocity.xy * ubo.deltaTime;
    particlesOut[index].particles.velocity = particlesIn[index].particles.velocity;

    // Flip movement at window border
    if ((particlesOut[index].particles.position.x <= -1.0) || (particlesOut[index].particles.position.x >= 1.0)) {
        particlesOut[index].particles.velocity.x = -particlesOut[index].particles.velocity.x;
    }
    if ((particlesOut[index].particles.position.y <= -1.0) || (particlesOut[index].particles.position.y >= 1.0)) {
        particlesOut[index].particles.velocity.y = -particlesOut[index].particles.velocity.y;
    }

}
着色器的上半部分是它的输入声明。 首先是位于绑定 0 的统一缓冲区对象,这一点本教程前面已经讲过。 接着我们声明与 C++ 代码中一致的 Particle 结构体。 绑定 1 引用的是装着上一帧粒子数据的着色器存储缓冲区对象(见描述符设置)。 绑定 2 指向当前帧的 SSBO,也就是这个着色器要更新的那一个。
还有一处有趣的地方,是这条只属于计算、与计算空间有关的声明:
[numthreads(256,1,1)]它定义了当前工作组中这个计算着色器的调用次数。
如前所述,这是计算空间中的局部部分。
由于我们处理的是一维线性粒子数组,在 [numthreads(x,y,z)] 里只需给 x 维度一个数。
随后 compMain 函数从上一帧的 SSBO 读取数据,把更新后的粒子位置写入当前帧的 SSBO。
与其他着色器类型类似,计算着色器也有自己的内置输入变量。
我们传入的 ThreadId 是一个能在当前调度范围内唯一标识当前计算着色器调用的变量,而它之所以具备这种能力,靠的是 SV_DispatchThreadID 注解。
我们用它对粒子数组做索引。
运行计算命令
调度
现在该真正让 GPU 做一些计算了。
办法是在命令缓冲区里调用 computeCommandBuffers[frameIndex]→dispatch。
虽然不完全准确,但可以这样类比:调度之于计算,就像 commandBuffers[frameIndex]→draw 之于图形。
它最多会在三个维度上派发给定数量的计算工作项。
computeCommandBuffers[frameIndex]->begin({});
...

computeCommandBuffers[frameIndex]->bindPipeline(vk::PipelineBindPoint::eCompute, *computePipeline);
computeCommandBuffers[frameIndex]->bindDescriptorSets(vk::PipelineBindPoint::eCompute, *computePipelineLayout, 0, {computeDescriptorSets[frameIndex]}, {});

computeCommandBuffers[frameIndex]->dispatch( PARTICLE_COUNT / 256, 1, 1 );

...

computeCommandBuffers[frameIndex]->end();
computeCommandBuffers[frameIndex]→dispatch 会在 x 维度上调度 PARTICLE_COUNT / 256 个局部工作组。
由于粒子数组是线性的,另外两个维度保持为 1,于是形成一维调度。
但为什么要用粒子数除以 256 呢?
因为上一段里我们规定,工作组中每个计算着色器会做 256 次调用。
所以如果有 4096 个粒子,就要调度 16 个工作组,每个工作组运行 256 次计算着色器调用。
要让这两个数值配合得当,通常得反复试验并做性能分析,具体取决于你的工作负载和所用硬件。
如果你的粒子数量是动态的、未必总能被 256 之类整除,那也总有办法:在计算着色器开头检查 gl_GlobalInvocationID,一旦全局调用索引超过粒子数量就直接返回。
而且正如计算管线的情况一样,计算命令缓冲区的状态比图形命令缓冲区少得多。 既不需要开始渲染通道,也不需要设置视口。
提交工作
由于我们的示例既有计算操作也有图形操作,每帧都要向计算队列和图形队列各提交一次(见 drawFrame 函数):
...
computeQueue->submit(submitInfo, **computeInFlightFences[frameIndex]);
...
graphicsQueue->submit(submitInfo, **inFlightFences[frameIndex]);
第一次提交到计算队列,用计算着色器更新粒子位置;第二次提交则使用更新后的数据绘制粒子系统。
同步图形与计算
同步是 Vulkan 中的重要一环,把计算与图形结合使用时更是如此。 同步出错或缺失,可能会导致顶点阶段在计算着色器尚未完成更新(写入)时就开始绘制(读取)粒子(读后写冒险),或者计算着色器在管线中顶点部分仍在使用粒子时就开始更新它们(写后读冒险)。
所以我们必须正确同步图形与计算负载,确保这两种情况不会发生。 具体做法取决于你如何提交计算工作负载;在我们这个分两次提交的例子里,我们会用 信号量和 栅栏来保证顶点着色器要等计算着色器更新完成后才开始取顶点。
这是必要的,因为即便两次提交在顺序上一个接一个,也不能保证它们在 GPU 上按这个顺序执行。 加上等待信号量和发信号这两步,才能确保这一执行顺序。
于是我们先在 createSyncObjects 中为计算工作新增一组同步原语。
计算栅栏与图形栅栏一样,要以已触发状态创建,否则第一次绘制会在等待栅栏触发时超时,详情见 这里:
std::vector<std::unique_ptr<vk::raii::Fence>> computeInFlightFences;
std::vector<std::unique_ptr<vk::raii::Semaphore>> computeFinishedSemaphores;
...
computeInFlightFences.resize(MAX_FRAMES_IN_FLIGHT);
computeFinishedSemaphores.resize(MAX_FRAMES_IN_FLIGHT);

for (size_t i = 0; i < MAX_FRAMES_IN_FLIGHT; i++) {
    ...
    computeFinishedSemaphores[i] = std::make_unique<vk::raii::Semaphore>(*device, vk::SemaphoreCreateInfo());
    computeInFlightFences[i] = std::make_unique<vk::raii::Fence>(*device, vk::FenceCreateInfo(vk::FenceCreateFlagBits::eSignaled));
}
接着用它们来让计算缓冲区的提交与图形提交保持同步:
{
    // Compute submission
    while ( vk::Result::eTimeout == device->waitForFences(**computeInFlightFences[frameIndex], vk::True, UINT64_MAX) )
        ;

    updateUniformBuffer(frameIndex);
    device->resetFences( **computeInFlightFences[frameIndex] );
    computeCommandBuffers[frameIndex]->reset();
    recordComputeCommandBuffer();

    const vk::SubmitInfo submitInfo({}, {}, {**computeCommandBuffers[frameIndex]}, { **computeFinishedSemaphores[frameIndex]});
    computeQueue->submit(submitInfo, **computeInFlightFences[frameIndex]);
}
{
    // Graphics submission
    while ( vk::Result::eTimeout == device->waitForFences(**inFlightFences[frameIndex], vk::True, UINT64_MAX))
...

    device->resetFences(  **inFlightFences[frameIndex] );
    commandBuffers[frameIndex]->reset();
    recordCommandBuffer(imageIndex);

    vk::Semaphore waitSemaphores[] = {**presentCompleteSemaphore[frameIndex], **computeFinishedSemaphores[frameIndex]};
    vk::PipelineStageFlags waitDestinationStageMask[] = { vk::PipelineStageFlagBits::eVertexInput, vk::PipelineStageFlagBits::eColorAttachmentOutput };
    const vk::SubmitInfo submitInfo( waitSemaphores, waitDestinationStageMask, {**commandBuffers[frameIndex]}, {**renderFinishedSemaphore[frameIndex]} );
    graphicsQueue->submit(submitInfo, **inFlightFences[frameIndex]);
与 信号量那一章的示例类似,这套设置会立刻运行计算着色器,因为这里没有指定任何等待信号量。
注意上面用了作用域花括号,是为了确保所用的 RAII 临时变量有机会在计算阶段与图形阶段之间自行清理。
这没问题,因为在计算提交之前,我们已经通过 device→waitForFences 命令等待当前帧的计算命令缓冲区执行完毕。
而图形提交这一边需要等计算工作完成,这样才不会在计算缓冲区还在更新顶点时去取顶点。
所以我们要等当前帧的 computeFinishedSemaphores,并让图形提交在消费顶点的 vk::PipelineStageFlagBits::eVertexInput 阶段等待。
但它还需要等待呈现完成,这样片元着色器在图像被呈现前不会向颜色附件输出。
因此我们还要在当前帧的 imageAvailableSemaphores 上、于 vk::PipelineStageFlagBits::eColorAttachmentOutput 阶段等待。
时间线信号量:一种改进的同步机制
上面描述的同步方式使用的是二值信号量,只有已触发/未触发两种状态。虽然这在许多场景下都很好用,但 Vulkan 还提供了更强大的同步原语:时间线信号量。
时间线信号量最初以扩展形式引入,后来在 Vulkan 1.2 中提升为核心特性。与二值信号量不同,时间线信号量带有一个 64 位无符号整数计数器值,可以等待它到达某个值,也可以把它触发到某个值。相比二值信号量,这带来若干优势:
-
可复用:一个时间线信号量就能用于多个同步点,从而减少所需的信号量数量。
-
主机侧同步:可以在主机(CPU)上触发和等待时间线信号量,无需向队列提交命令。
-
乱序触发:你可以把时间线信号量触发到高于当前等待值的值,从而实现更灵活的同步模式。
-
多个待处理信号:二值信号量只能有一个待处理的信号,而时间线信号量可以有多个。
下面来看看如何把粒子系统示例改造成使用时间线信号量而非二值信号量:
首先,需要在创建逻辑设备时启用时间线信号量特性:
vk::PhysicalDeviceTimelineSemaphoreFeaturesKHR timelineSemaphoreFeatures;
timelineSemaphoreFeatures.timelineSemaphore = vk::True;
// Chain this to your device creation info
然后不再创建多个二值信号量,而是创建一个时间线信号量:
vk::SemaphoreTypeCreateInfo semaphoreType{ .semaphoreType = vk::SemaphoreType::eTimeline, .initialValue = 0 };
semaphore = vk::raii::Semaphore(device, {.pNext = &semaphoreType});
timelineValue = 0;
在绘制帧的函数里,我们用递增的时间线值来协调计算与图形之间的工作:
// Update timeline value for this frame
uint64_t computeWaitValue = timelineValue;
uint64_t computeSignalValue = ++timelineValue;
uint64_t graphicsWaitValue = computeSignalValue;
uint64_t graphicsSignalValue = ++timelineValue;
计算提交这边,我们使用时间线信号量的提交信息结构:
vk::TimelineSemaphoreSubmitInfo computeTimelineInfo{
    .waitSemaphoreValueCount = 1,
    .pWaitSemaphoreValues = &computeWaitValue,
    .signalSemaphoreValueCount = 1,
    .pSignalSemaphoreValues = &computeSignalValue
};

vk::PipelineStageFlags waitStages[] = {vk::PipelineStageFlagBits::eComputeShader};

vk::SubmitInfo computeSubmitInfo{
    .pNext = &computeTimelineInfo,
    .waitSemaphoreCount = 1,
    .pWaitSemaphores = &*semaphore,
    .pWaitDstStageMask = waitStages,
    .commandBufferCount = 1,
    .pCommandBuffers = &*computeCommandBuffers[frameIndex],
    .signalSemaphoreCount = 1,
    .pSignalSemaphores = &*semaphore
};

computeQueue.submit(computeSubmitInfo, nullptr);
图形提交这边同理:
vk::PipelineStageFlags waitStage = vk::PipelineStageFlagBits::eVertexInput;
vk::TimelineSemaphoreSubmitInfo graphicsTimelineInfo{
    .waitSemaphoreValueCount = 1,
    .pWaitSemaphoreValues = &graphicsWaitValue,
    .signalSemaphoreValueCount = 1,
    .pSignalSemaphoreValues = &graphicsSignalValue
};

vk::SubmitInfo graphicsSubmitInfo{
    .pNext = &graphicsTimelineInfo,
    .waitSemaphoreCount = 1,
    .pWaitSemaphores = &*semaphore,
    .pWaitDstStageMask = &waitStage,
    .commandBufferCount = 1,
    .pCommandBuffers = &*commandBuffers[frameIndex],
    .signalSemaphoreCount = 1,
    .pSignalSemaphores = &*semaphore
};

graphicsQueue.submit(graphicsSubmitInfo, nullptr);
在呈现之前,我们要等图形工作完成:
vk::SemaphoreWaitInfo waitInfo{
    .semaphoreCount = 1,
    .pSemaphores = &*semaphore,
    .pValues = &graphicsSignalValue
};

// Wait for graphics to complete before presenting
auto result = device.waitSemaphores(waitInfo, UINT64_MAX);
if (result != vk::Result::eSuccess)
{
    throw std::runtime_error("failed to wait for semaphore!");
}

vk::PresentInfoKHR presentInfo{
    .waitSemaphoreCount = 0, // No binary semaphores needed
    .pWaitSemaphores = nullptr,
    .swapchainCount = 1,
    .pSwapchains = &*swapChain,
    .pImageIndices = &imageIndex
};
相比二值信号量的实现,时间线信号量的做法有若干好处:
-
资源管理更简单:每个在途帧只需一个信号量,而不是多个。
-
同步更明确:时间线值让哪些操作互相依赖一目了然。
-
开销更低:同步对象更少,管理它们的开销也就更小。
-
同步模式更灵活:时间线信号量能支撑更复杂的同步场景,而这些用二值信号量很难实现。
在存在多个相互依赖操作的场景里——比如我们这个先计算后图形的流程——或者需要在主机与设备之间同步时,时间线信号量尤其有用。它提供了一种更强大、更灵活的同步机制,既能简化代码,又能实现更复杂的同步模式。
绘制粒子系统
前面我们了解到,Vulkan 中的缓冲区可以有多种用途,因此创建存放粒子的着色器存储缓冲区时,我们同时带上了着色器存储缓冲区位和顶点缓冲区位。 这意味着,我们可以像前几章使用“纯”顶点缓冲区那样,用这个着色器存储缓冲区来绘制。
首先,我们把顶点输入状态设置成与粒子结构体相匹配:
struct Particle {
    ...

    static std::array<vk::VertexInputAttributeDescription, 2> getAttributeDescriptions() {
        return {
            vk::VertexInputAttributeDescription( 0, 0, vk::Format::eR32G32Sfloat, offsetof(Particle, position) ),
            vk::VertexInputAttributeDescription( 1, 0, vk::Format::eR32G32B32A32Sfloat, offsetof(Particle, color) ),
        };
    }
};
注意我们没有把 velocity 加进顶点输入属性,因为它只供计算着色器使用。
然后像对待任何顶点缓冲区那样绑定并绘制它:
commandBuffers[frameIndex]->bindVertexBuffers(0, { *shaderStorageBuffers[frameIndex] }, {0});

commandBuffers[frameIndex]->draw( PARTICLE_COUNT, 1, 0, 0 );
结论
本章我们学习了如何用计算着色器把工作从 CPU 卸载到 GPU。 没有计算着色器,现代游戏和应用中的许多效果要么根本做不出来,要么会慢得多。 但计算比图形拥有更多用途,本章只是让你瞥见其中一角。 既然你已经知道怎么用计算着色器了,不妨再看看一些高级计算话题,例如:
你可以在 Khronos 官方 Vulkan 示例仓库里找到一些高级计算示例。
C++ 代码 / slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器 / GLSL 计算着色器