引言
在真实应用中渲染的 3D 网格,顶点往往会在多个三角形之间共享。即便只是 绘制一个矩形这样简单的任务,就已经如此:
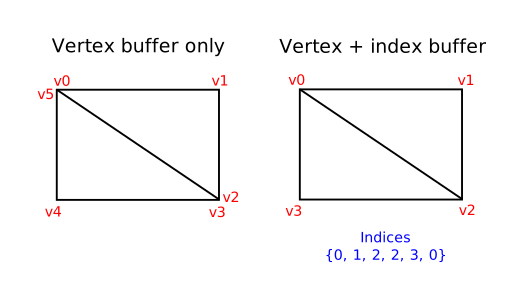
绘制一个矩形需要两个三角形,也就是说顶点缓冲区里要有六个顶点。问题在于 其中两个顶点的数据必须重复,造成 50% 的冗余。网格越复杂情况越糟,平均每 个顶点会被三个三角形复用。这个问题的解决方案是使用索引缓冲区。
索引缓冲区本质上是一个存放指向顶点缓冲区的索引的数组。它让你能重排顶点 数据,并让多个顶点复用已有的数据。上图展示了:如果顶点缓冲区包含四个 不重复的顶点,矩形的索引缓冲区会是什么样子。前三个索引定义右上角的 三角形,后三个索引定义左下角三角形的顶点。
创建索引缓冲区
本章我们要修改顶点数据,并加入索引数据,来绘制图中那样的矩形。把顶点 数据改成表示四个角:
const std::vector<Vertex> vertices = {
    {{-0.5f, -0.5f}, {1.0f, 0.0f, 0.0f}},
    {{0.5f, -0.5f}, {0.0f, 1.0f, 0.0f}},
    {{0.5f, 0.5f}, {0.0f, 0.0f, 1.0f}},
    {{-0.5f, 0.5f}, {1.0f, 1.0f, 1.0f}}
};
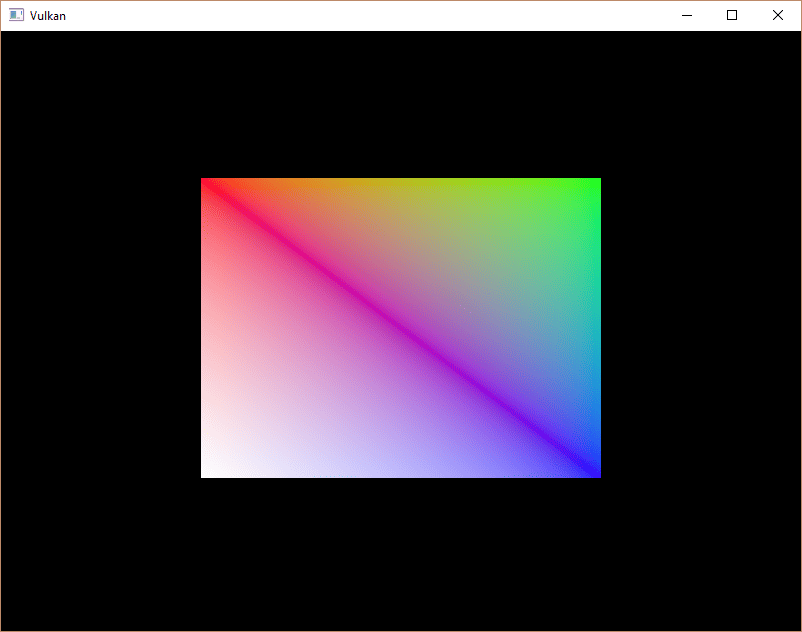
左上角是红色,右上角是绿色,右下角是蓝色,左下角是白色。我们再添加一个
indices 数组,表示索引缓冲区的内容。它应当与图中的索引一致,以便画出
右上角和左下角的三角形。
const std::vector<uint16_t> indices = {
    0, 1, 2, 2, 3, 0
};
根据 vertices 中元素的数量,索引缓冲区可以用 uint16_t 或 uint32_t。
目前不重复的顶点不到 65535 个,所以先用 uint16_t 就好。
和顶点数据一样,索引也需要上传到 vk::raii::Buffer 中,GPU 才能访问。
定义两个新的类成员来保存索引缓冲区的资源:
vk::raii::Buffer       vertexBuffer       = nullptr;
vk::raii::DeviceMemory vertexBufferMemory = nullptr;
vk::raii::Buffer       indexBuffer        = nullptr;
vk::raii::DeviceMemory indexBufferMemory  = nullptr;
接下来要添加的 createIndexBuffer 函数与 createVertexBuffer 几乎完全
相同:
void initVulkan()
{
    ...
    createVertexBuffer();
    createIndexBuffer();
    ...
}

void createIndexBuffer()
{
		vk::DeviceSize bufferSize = sizeof(indices[0]) * indices.size();

		auto [stagingBuffer, stagingBufferMemory] =
		    createBuffer(bufferSize, vk::BufferUsageFlagBits::eTransferSrc, vk::MemoryPropertyFlagBits::eHostVisible | vk::MemoryPropertyFlagBits::eHostCoherent);

		void *data = stagingBufferMemory.mapMemory(0, bufferSize);
		memcpy(data, indices.data(), (size_t) bufferSize);
		stagingBufferMemory.unmapMemory();

		std::tie(indexBuffer, indexBufferMemory) =
		    createBuffer(bufferSize, vk::BufferUsageFlagBits::eIndexBuffer | vk::BufferUsageFlagBits::eTransferDst, vk::MemoryPropertyFlagBits::eDeviceLocal);

		copyBuffer(stagingBuffer, indexBuffer, bufferSize);
}只有两处明显不同。bufferSize 现在等于索引数量乘以索引类型(uint16_t 或
uint32_t)的大小。indexBuffer 的用途应改为
vk::BufferUsageFlagBits::eIndexBuffer,而不是
vk::BufferUsageFlagBits::eVertexBuffer,这很合理。除此之外,流程完全
一样。我们创建一个暂存缓冲区,把 indices 的内容复制进去,再把它复制到
最终的设备本地索引缓冲区。
使用索引缓冲区
用索引缓冲区绘制需要改动 recordCommandBuffer 的两处。首先像顶点缓冲区
那样绑定索引缓冲区。区别在于你只能有一个索引缓冲区。很遗憾,无法为每个
顶点属性分别使用不同的索引,所以即使只有一个属性不同,也仍然必须完整
复制顶点数据。
commandBuffers[frameIndex].bindVertexBuffers(0, *vertexBuffer, {0});
commandBuffers[frameIndex].bindIndexBuffer(*indexBuffer, 0, vk::IndexType::eUint16);
索引缓冲区用 vk::raii::CommandBuffer::bindIndexBuffer 绑定,参数包括
索引缓冲区、它内部的字节偏移,以及索引数据的类型。前面提过,可用的类型有
vk::IndexType::eUint16 和 vk::IndexType::eUint32。
只绑定索引缓冲区还不会改变什么,还需要修改绘制命令,告诉 Vulkan 使用
索引缓冲区。删掉 vk::raii::CommandBuffer::draw 那一行,换成
vk::raii::CommandBuffer::drawIndexed:
commandBuffer.drawIndexed(static_cast<uint32_t>(indices.size()), 1, 0, 0, 0);调用这个函数与 vk::raii::CommandBuffer::draw 非常相似。前两个参数指定
索引数量和实例数量。我们没有使用实例化,所以实例数写 1。索引数量表示
将传给顶点着色器的顶点数。下一个参数指定索引缓冲区内的偏移,值为 1
会让显卡从第二个索引开始读取。倒数第二个参数指定在按索引访问顶点缓冲区
之前加到顶点索引上的偏移。最后一个参数指定实例化用的偏移,我们没有用到。
现在运行程序,应该会看到:
现在你已经知道如何用索引缓冲区复用顶点来节省内存。在以后要加载复杂 3D 模型的章节里,这一点会格外重要。
上一章已经提到,像缓冲区这样的多个资源应当从单次内存分配中划出,但事实上
还可以更进一步。
驱动开发者建议,
把顶点缓冲区和索引缓冲区等多个缓冲区也存进同一个 vk::raii::Buffer,并在
vk::raii::CommandBuffer::bindVertexBuffers 之类的命令中使用偏移。这样做
的好处是数据排布更紧凑,对缓存更友好。如果多个资源不会在同一次渲染操作
中使用,甚至可以复用同一块内存,当然前提是刷新它们的数据。这种做法称为
别名(aliasing),有些 Vulkan 函数提供了显式标志来表明你要这样做。
在 下一章里, 我们会学习如何把频繁变化的参数传给 GPU。
C++ 代码 / Slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器