return float4(vertIn.fragColor * texture.Sample(vertIn.fragTexCoord).rgb, 1.0);引言
你的程序现在可以渲染带纹理的 3D 网格了,但目前 vertices 和 indices 数组里的几何体还相当无趣。本章我们会扩展程序,从真正的模型文件中加载顶点和索引,好让显卡真正干点活。
很多图形 API 教程会在这个阶段让读者自己写一个 OBJ 加载器。问题在于,任何稍微像样的 3D 应用很快都会需要这种文件格式并不支持的特性,比如骨骼动画。本章我们确实会从 OBJ 模型加载网格数据,但重点放在如何把网格数据与程序本身结合起来,而不是从文件加载它的细节。
库
我们将用 tinyobjloader 库从 OBJ 文件加载顶点和面。它速度快,也容易集成,因为和 stb_image 一样是单文件库。这个库在 开发环境一章已经提到过,应当已经是本教程这部分所需依赖的一部分。
更新片元着色器
在 组合图像采样器一章中,我们把采样得到的纹理颜色与插值后的逐顶点颜色相乘,以演示两者确实被组合在了一起:
接下来要加载的模型把光照直接烘焙进了纹理,并没有设置有意义的逐顶点颜色,因此那次乘法只会给模型染上一层不该有的颜色。请把片元着色器的 fragMain 改回直接采样纹理,不再涉及逐顶点颜色:
return texture.Sample(vertIn.fragTexCoord);如果跳过这一步,那么等你做到本章末尾时,模型渲染出来的颜色会明显不对。
示例网格
本章还不会启用光照,所以使用一个把光照烘焙进纹理的示例模型会省事很多。找这类模型的一个简便办法,是在 Sketchfab 上搜索 3D 扫描模型。该网站上的许多模型都以 OBJ 格式提供,许可也较为宽松。
本教程选用的是 nigelgoh 制作的 Viking room 模型(https://web.archive.org/web/20200428202538/https://sketchfab.com/3d-models/viking-room-a49f1b8e4f5c4ecf9e1fe7d81915ad38[CC BY 4.0])。我调整了模型的尺寸和朝向,使其可以直接替换当前的几何体:
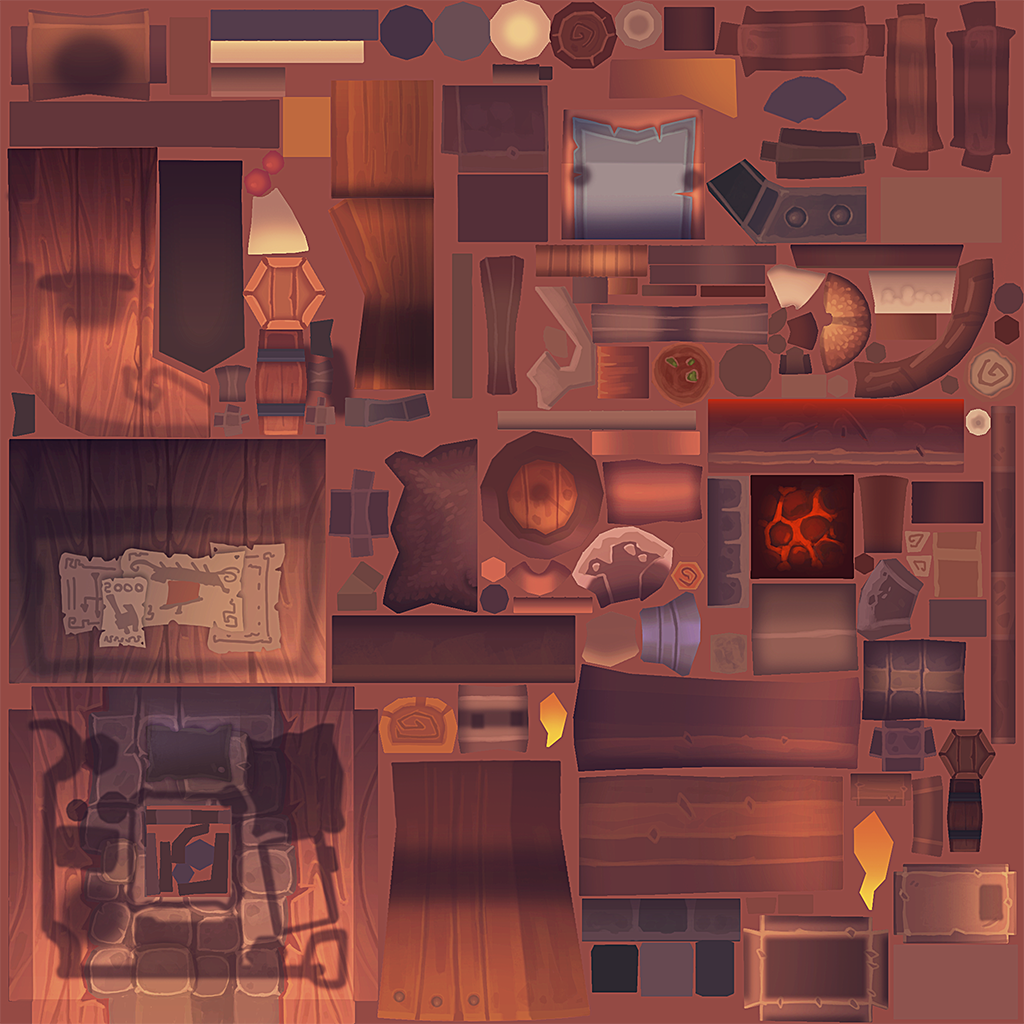
你也可以换成自己的模型,但要确保它只包含一种材质,并且尺寸约为 1.5 x 1.5 x 1.5 个单位。如果比这更大,就得修改视图矩阵。把模型文件放进新建的 models 目录,与 shaders 和 textures 并列,纹理图像则放进 textures 目录。
在程序里新增两个配置变量,分别定义模型路径和纹理路径:
constexpr uint32_t WIDTH                = 800;
constexpr uint32_t HEIGHT               = 600;
const std::string  MODEL_PATH           = "models/viking_room.obj";
const std::string  TEXTURE_PATH         = "textures/viking_room.png";
并让 createTextureImage 使用这个路径变量:
stbi_uc* pixels = stbi_load(TEXTURE_PATH.c_str(), &texWidth, &texHeight, &texChannels, STBI_rgb_alpha);加载顶点和索引
现在要从模型文件加载顶点和索引,所以应当删掉全局的 vertices 和 indices 数组,替换为非 const 的容器,作为类成员:
std::vector<Vertex>    vertices;
std::vector<uint32_t>  indices;
vk::raii::Buffer       vertexBuffer       = nullptr;
vk::raii::DeviceMemory vertexBufferMemory = nullptr;
vk::raii::Buffer       indexBuffer        = nullptr;
vk::raii::DeviceMemory indexBufferMemory  = nullptr;
索引的类型要从 uint16_t 改成 uint32_t,因为顶点数量会远超 65535。略显复杂的写法 vk::IndexTypeValue<decltype(indices)::value_type>::value 会自动取得索引的类型。
commandBuffer.bindIndexBuffer(*indexBuffer, 0, vk::IndexTypeValue<decltype(indices)::value_type>::value);tinyobjloader 库的引入方式与 STB 系列库相同。包含 tiny_obj_loader.h 文件,并确保在某个源文件中定义 TINYOBJLOADER_IMPLEMENTATION,以便把函数体包含进来、避免链接错误:
#define TINYOBJLOADER_IMPLEMENTATION
#include <tiny_obj_loader.h>
接下来编写一个 loadModel 函数,借助这个库把网格中的顶点数据填入 vertices 和 indices 容器。它应当在创建顶点缓冲区和索引缓冲区之前被调用:
void initVulkan()
{
    ...
    loadModel();
    createVertexBuffer();
    createIndexBuffer();
    ...
}

...

void loadModel()
{
}
调用 tinyobj::LoadObj 函数,就能把模型加载到该库的数据结构中:
void loadModel()
{
		tinyobj::attrib_t                attrib;
		std::vector<tinyobj::shape_t>    shapes;
		std::vector<tinyobj::material_t> materials;
		std::string                      warn, err;

		if (!tinyobj::LoadObj(&attrib, &shapes, &materials, &warn, &err, MODEL_PATH.c_str()))
		{
			throw std::runtime_error(warn + err);
		}
}
OBJ 文件由位置、法线、纹理坐标和面组成。面由任意数量的顶点构成,每个顶点通过索引指向一个位置、法线和/或纹理坐标。这样不仅可以复用整个顶点,还能复用单个属性。
attrib 容器在 attrib.vertices、attrib.normals 和 attrib.texcoords 这几个向量中保存全部位置、法线和纹理坐标。shapes 容器包含所有独立对象及其面。每个面由一组顶点组成,每个顶点则含有位置、法线和纹理坐标属性的索引。OBJ 模型还可以为每个面定义材质和纹理,但我们会忽略它们。
err 字符串包含加载文件时出现的错误,warn 字符串包含警告,例如缺少材质定义。只有 LoadObj 函数返回 false 时,加载才算真正失败。如前所述,OBJ 文件中的面实际上可以包含任意数量的顶点,而我们的应用只能渲染三角形。好在 LoadObj 有一个可选参数能自动把这类面三角化,而且这个参数默认就是开启的。
我们要把文件中的所有面合并成一个模型,所以直接遍历所有形状即可:
for (const auto& shape : shapes)
{
}
三角化功能已经确保每个面有三个顶点,因此现在可以直接遍历顶点,把它们原样塞进 vertices 向量:
for (const auto& shape : shapes)
{
    for (const auto& index : shape.mesh.indices)
    {
        Vertex vertex{};

        vertices.push_back(vertex);
        indices.push_back(indices.size());
    }
}为了简单起见,这里先假定每个顶点都是唯一的,所以索引就是简单的自增。index 变量的类型是 tinyobj::index_t,其中包含 vertex_index、normal_index 和 texcoord_index 成员。我们需要用这些索引到 attrib 数组里查出真正的顶点属性:
vertex.pos = {
    attrib.vertices[3 * index.vertex_index + 0],
    attrib.vertices[3 * index.vertex_index + 1],
    attrib.vertices[3 * index.vertex_index + 2]
};

vertex.texCoord = {
    attrib.texcoords[2 * index.texcoord_index + 0],
    attrib.texcoords[2 * index.texcoord_index + 1]
};

vertex.color = {1.0f, 1.0f, 1.0f};遗憾的是,attrib.vertices 数组是 float 值数组,而不是 glm::vec3 之类的东西,所以需要把索引乘以 3。类似地,每个条目有两个纹理坐标分量。偏移 0、1 和 2 用于访问 X、Y、Z 分量;对纹理坐标来说则是 U 和 V 分量。
现在运行程序,你应该会看到类似下面的结果:
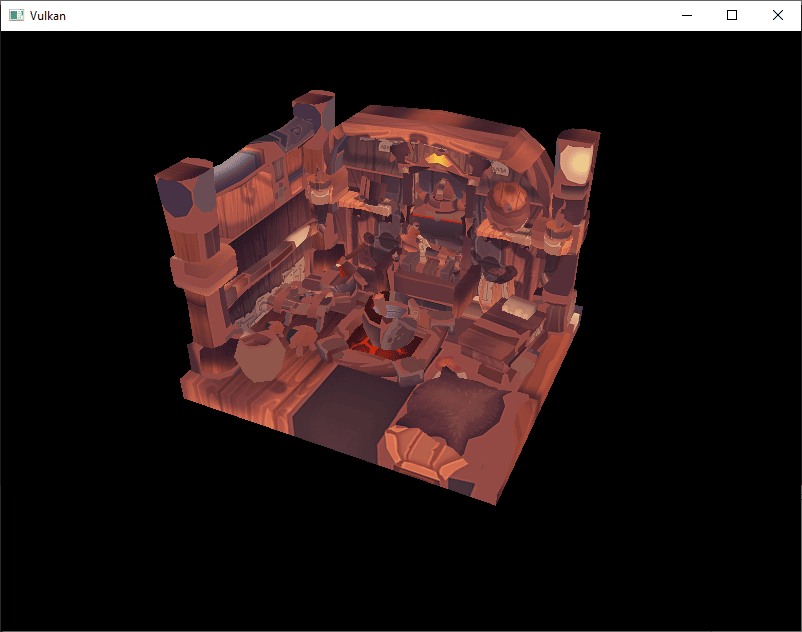
很好,几何体看起来是对的,但纹理是怎么回事?OBJ 格式假定垂直坐标 0 表示图像底部,而我们上传到 Vulkan 的图像是从上到下排列的,0 表示图像顶部。把纹理坐标的垂直分量翻转一下即可解决:
vertex.texCoord = {
    attrib.texcoords[2 * index.texcoord_index + 0],
    1.0f - attrib.texcoords[2 * index.texcoord_index + 1]
};
再次运行程序,现在应该能看到正确的结果:
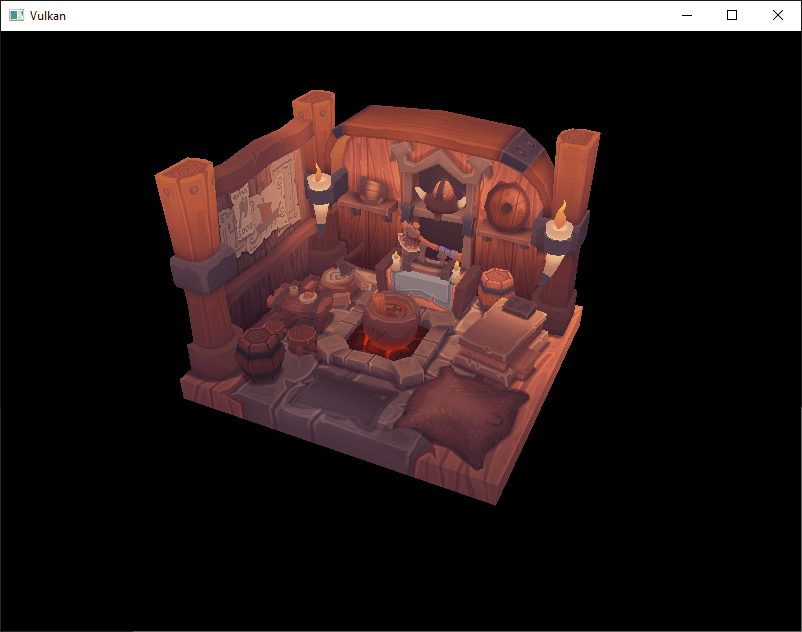
这么多辛苦终于开始有回报,做出了这样一个演示!
模型旋转时,你可能会发现背面(墙的内侧)看起来有点怪。这是正常的,只是因为模型本来就不是为了从那个方向观看而设计的。
顶点去重
遗憾的是,我们还没有真正利用起索引缓冲区的优势。vertices 向量里存在大量重复的顶点数据,因为许多顶点同时属于多个三角形。我们应当只保留唯一的顶点,并在它们再次出现时通过索引缓冲区复用。实现这一点的直接办法,是用 map 或 unordered_map 记录唯一顶点及对应的索引:
#include <unordered_map>

...

std::unordered_map<Vertex, uint32_t> uniqueVertices{};

for (const auto& shape : shapes)
{
    for (const auto& index : shape.mesh.indices)
    {
        Vertex vertex{};

        ...

				auto [it, inserted] = uniqueVertices.insert({vertex, static_cast<uint32_t>(vertices.size())});
				if (inserted)
				{
            vertices.push_back(vertex);
				}

				indices.push_back(it->second);
    }
}
每次从 OBJ 文件读到一个顶点,我们就插入 { vertex, index } 对,其中的索引是 vertices 数组当前的长度。只有当顶点确实被 inserted 时,才会同时设定索引值;否则映射表中该 vertex 对应的索引保持不变。而如果顶点被 inserted,我们就把它存进 vertices。无论哪种情况,该顶点在 vertices 向量中的索引都会加入 indices 向量。
现在程序会编译失败,因为要用 Vertex 结构体这样的用户自定义类型作为哈希表的键,必须实现两个函数:相等性测试和哈希计算。前者很容易实现:重载 == 运算符,写在 Vertex 结构体中:
bool operator==(const Vertex& other) const
{
    return pos == other.pos && color == other.color && texCoord == other.texCoord;
}
为 Vertex 实现哈希函数,则是为 std::hash<T> 指定一个模板特化。哈希函数是个复杂话题,不过 cppreference.com 建议采取下面的做法:把结构体的各个字段组合起来,从而得到质量不错的哈希函数:
namespace std
{
    template<> struct hash<Vertex>
    {
        size_t operator()(Vertex const& vertex) const
        {
            return ((hash<glm::vec3>()(vertex.pos) ^ (hash<glm::vec3>()(vertex.color) << 1)) >> 1) ^ (hash<glm::vec2>()(vertex.texCoord) << 1);
        }
    };
}
这段代码应放在 Vertex 结构体之外。GLM 类型的哈希函数需要包含以下头文件:
#define GLM_ENABLE_EXPERIMENTAL
#include <glm/gtx/hash.hpp>
这些哈希函数定义在 gtx 文件夹中,也就是说严格来讲它仍是 GLM 的实验性扩展。因此必须定义 GLM_ENABLE_EXPERIMENTAL 才能使用。这意味着该 API 在未来某个 GLM 版本中可能发生变化,但实践中它非常稳定。
现在你应该能顺利编译并运行程序了。查看 vertices 的大小,会看到它从 11,484 缩减到了 3,566!这意味着平均每个顶点被约 3 个三角形复用。这无疑为我们省下了大量 GPU 内存。
在 下一章,我们将学习一种改进纹理渲染的技术。
C++ 代码 / Slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器