#define STB_IMAGE_IMPLEMENTATION
#include <stb_image.h>简介
到目前为止,几何体一直用逐顶点颜色着色,这种方式相当受限。 在本部分教程中,我们将实现纹理映射,让几何体看起来更有意思。 这也使我们能在后续章节中加载并绘制基本的 3D 模型。
为应用添加纹理需要以下步骤:
-
创建一个由设备内存支持的图像对象
-
用图像文件中的像素填充它
-
创建一个图像采样器
-
添加一个组合图像采样器描述符,以便从纹理中采样颜色
我们此前已经用过图像对象,但那些都是交换链扩展自动创建的。 这一次得由我们自己创建一个。 创建图像并用数据填充它,与创建顶点缓冲区相似,但由于 GPU 处理图像的方式,会多出一些复杂之处。 我们先创建一个暂存资源并用像素数据填充,然后把它复制到最终用于渲染的图像对象。 虽然可以为此创建暂存图像,但 Vulkan 也允许直接从缓冲区把像素复制到图像。这种写法更简短、限制更少,而且通常 更快。 为此,我们先创建一个主机可访问的缓冲区并填入像素值,再创建一个图像,把像素复制过去。 创建图像与创建缓冲区差别不大。 同样要查询内存需求、分配设备内存并绑定,和之前见过的一样。
不过,处理图像时还有额外一点需要注意。 图像可以有不同的 布局,它影响像素在内存中的组织方式。 例如,受图形硬件工作方式的影响,仅仅逐行存储像素未必能带来最佳性能。 对图像执行任何操作时,都必须确保它处于该操作所需的最优布局。 实际上,我们在指定渲染通道时已经见过其中一些布局:
-
vk::ImageLayout::ePresentSrcKHR:最适合呈现 -
vk::ImageLayout::eColorAttachmentOptimal:最适合作为附件,接收片元着色器写入的颜色 -
vk::ImageLayout::eTransferSrcOptimal:最适合作为传输操作的源,例如vk::raii::CommandBuffer::copyImageToBuffer -
vk::ImageLayout::eTransferDstOptimal:最适合作为传输操作的目标,例如vk::raii::CommandBuffer::copyBufferToImage -
vk::ImageLayout::eShaderReadOnlyOptimal:最适合供着色器采样
转换图像布局最常见的方式之一是 管线屏障。
管线屏障主要用于同步对资源的访问,例如确保图像在被读取之前已经写入完成,但它也可以用来转换布局。
本章中我们会看到管线屏障如何用于这一目的。
此外,在使用 vk::SharingMode::eExclusive 时,屏障还可用于转移队列族所有权。
加载图像
像这样引入图像库:
该头文件默认只声明函数原型。
需要有一个代码文件在包含该头文件时定义 STB_IMAGE_IMPLEMENTATION,才会把函数体也包含进来,否则会出现链接错误。
void initVulkan()
{
    ...
    createCommandPool();
    createTextureImage();
    createVertexBuffer();
    ...
}

...

void createTextureImage()
{
}
新建 createTextureImage 函数,我们将在其中加载图像并上传到 Vulkan 图像对象。
这里要用到命令缓冲区,所以它应在 createCommandPool 之后调用。
在 shaders 目录旁边新建一个 textures 目录,用来存放纹理图像。
我们将从该目录加载一张名为 texture.jpg 的图像。
我选择了下面这张 CC0 许可的图像,并缩放到 512 x 512 像素,你也可以随便挑一张自己喜欢的图。
该库支持大多数常见图像文件格式,例如 JPEG、PNG、BMP 和 GIF。
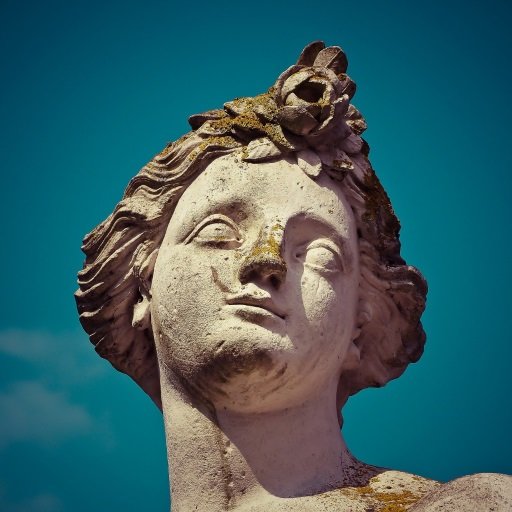
用这个库加载图像非常简单:
void createTextureImage()
{
    int            texWidth, texHeight, texChannels;
    stbi_uc       *pixels    = stbi_load("textures/texture.jpg", &texWidth, &texHeight, &texChannels, STBI_rgb_alpha);
    vk::DeviceSize imageSize = texWidth * texHeight * 4;

    if (!pixels)
    {
        throw std::runtime_error("failed to load texture image!");
    }
}
stbi_load 函数接收文件路径和要加载的通道数作为参数。
STBI_rgb_alpha 会强制以带 alpha 通道的方式加载图像,即使原图没有 alpha 通道;这样以后与其他纹理保持一致会比较方便。
中间三个参数是输出,分别返回图像的宽度、高度和实际通道数。
返回的指针指向像素值数组的第一个元素。
像素逐行排列,在 STBI_rgb_alpha 的情况下每个像素占 4 字节,总共有 texWidth * texHeight * 4 个值。
暂存缓冲区
接下来要把图像上传到 GPU,以便着色器读取时获得最优的访问性能。为此,我们会在主机可见内存中创建一个缓冲区,映射它并复制像素数据。这个缓冲区将作为把数据复制到 GPU 的源。
|
Note
|
图像应始终驻留在 GPU 内存中。如果把它留在仅主机可见的内存里,GPU 每帧都要通过 PCI 接口读取数据,而该接口的带宽远小于 GPU 内存的带宽,会造成很大的性能损失。暂存就是把图像数据送入 GPU 内存的过程。它并非总是必需,因为设备可能提供既主机可见又设备本地的内存类型,在这类配置上可以跳过暂存。 |
该缓冲区应位于主机可见内存(eHostVisible)中,这样才能映射它。它还应是主机一致的(eHostCoherent),以保证写入的数据立即可见(而不会被以某种方式缓存)。此外,它要能作为传输源('eTransferSrc')使用,以便之后把数据复制到图像:
返回值的类型会自动推导为 vk::raii::Buffer 和 vk::raii::DeviceMemory。
auto [stagingBuffer, stagingBufferMemory] =
    createBuffer(imageSize, vk::BufferUsageFlagBits::eTransferSrc, vk::MemoryPropertyFlagBits::eHostVisible | vk::MemoryPropertyFlagBits::eHostCoherent);
然后就可以把从图像加载库得到的像素值直接复制到缓冲区:
void* data = stagingBufferMemory.mapMemory(0, imageSize);
memcpy(data, pixels, imageSize);
stagingBufferMemory.unmapMemory();
记得现在把原始的像素数组清理掉:
stbi_image_free(pixels);纹理图像
虽然也可以让着色器去访问缓冲区里的像素值,但在 Vulkan 中更好的做法是使用图像对象。 一方面,图像对象允许用二维坐标取色,因此取色更简单也更快。 图像对象中的像素称为纹素(texel),从现在起我们就用这个叫法。 添加以下新的类成员:
vk::raii::Image        textureImage       = nullptr;
vk::raii::DeviceMemory textureImageMemory = nullptr;
图像的参数在 vk::ImageCreateInfo 结构体中指定:
vk::ImageCreateInfo imageInfo{.imageType   = vk::ImageType::e2D,
                              .format      = format,
                              .extent      = {width, height, 1},
                              .mipLevels   = 1,
                              .arrayLayers = 1,
                              .samples     = vk::SampleCountFlagBits::e1,
                              .tiling      = tiling,
                              .usage       = usage,
                              .sharingMode = vk::SharingMode::eExclusive};
imageType 字段指定图像类型,它告诉 Vulkan 图像中的纹素将按哪种坐标系寻址。
可以创建 1D、2D 和 3D 图像。
一维图像可用于存储数据数组或渐变,二维图像主要用于纹理,三维图像则可用于存储体素体积等。
extent 字段指定图像的尺寸,基本上就是每个轴上有多少纹素。
这也是 depth 必须为 1 而不是 0 的原因。
我们的纹理不是数组,目前也不会使用 mipmap。
Vulkan 支持多种图像格式,但我们应让纹素使用与缓冲区中像素相同的格式,否则复制操作会失败。
tiling 指定纹素在内存中的排布方式。Vulkan 为此支持两种本质不同的模式:
-
vk::ImageTiling::eOptimal:纹素按与实现相关的排布方式存放。这样内存访问效率更高。 -
vk::ImageTiling::eLinear:纹素按行主序存放在内存中,每行可能有若干填充字节。
|
Note
|
线性平铺图像限制很多。例如它们可能只对二维图像有效,不能用于深度/模板,也不能有多个 mip 层级或多个层。GPU 访问速度也远低于最优平铺图像。所以它们的适用场景非常少。 |
因此,我们将使用 vk::ImageTiling::eOptimal,以便着色器高效访问。
图像的 initialLayout 只有两种可选值:
-
vk::ImageLayout::eUndefined:GPU 不可使用,且第一次转换会丢弃其中的纹素。 -
vk::ImageLayout::ePreinitialized:GPU 不可使用,但第一次转换会保留其中的纹素。
只有极少数情况需要让纹素在第一次转换时被保留。 一个例子是想把线性平铺图像用作暂存图像。 这种情况下,你会希望先上传纹素数据,再把图像转换为传输源,同时不丢失数据。
不过在本文的场景中,我们先把图像转换为传输目标,然后从缓冲区对象把纹素数据复制进去,因此不需要这个属性,可以放心使用 vk::ImageLayout::eUndefined。
usage 字段的语义与创建缓冲区时相同。
图像要作为缓冲区复制的目标,因此应设置为传输目标。
我们还希望能在着色器中访问该图像来为网格着色,所以用途中要包含 vk::ImageUsageFlagBits::eSampled。
该图像只会被一个队列族使用:支持图形(因此也支持)传输操作的那个队列族。
samples 标志与多重采样有关。
它只对用作附件的图像有意义,所以这里保持单采样。
image = vk::raii::Image(device, imageInfo);图像通过 vk::raii::Image 构造函数创建,它并没有什么特别值得说明的参数。
vk::Format::eR8G8B8A8Srgb, 格式可能不被图形硬件支持。
你应该准备一份可接受格式的列表,并从中选用被支持的最佳格式。
不过这种格式的支持非常普遍,所以我们跳过这一步。
使用不同格式还会带来烦人的转换。
我们会在深度缓冲区章节回到这个话题,并在那里实现这样一套机制。
vk::MemoryRequirements memRequirements = image.getMemoryRequirements();
vk::MemoryAllocateInfo allocInfo{.allocationSize  = memRequirements.size,
                                 .memoryTypeIndex = findMemoryType(memRequirements.memoryTypeBits, properties)};
imageMemory = vk::raii::DeviceMemory(device, allocInfo);
image.bindMemory(imageMemory, 0);
为图像分配内存与为缓冲区分配内存完全相同。
使用默认的 vk::raii::DeviceMemory 构造函数,并对 image 调用 bindMemory。
这个函数已经变得相当长,而且后续章节还需要创建更多图像,所以我们应该像处理缓冲区那样,把图像创建抽象成 createImage 函数。
创建该函数,并把图像对象创建和内存分配移进去:
std::pair<vk::raii::Image, vk::raii::DeviceMemory> createImage(
  uint32_t width, uint32_t height, vk::Format format, vk::ImageTiling tiling, vk::ImageUsageFlags usage, vk::MemoryPropertyFlags properties )
{
  vk::ImageCreateInfo imageInfo{.imageType   = vk::ImageType::e2D,
                                .format      = format,
                                .extent      = {width, height, 1},
                                .mipLevels   = 1,
                                .arrayLayers = 1,
                                .samples     = vk::SampleCountFlagBits::e1,
                                .tiling      = tiling,
                                .usage       = usage,
                                .sharingMode = vk::SharingMode::eExclusive};

  vk::raii::Image image = vk::raii::Image(device, imageInfo);

  vk::MemoryRequirements memRequirements = image.getMemoryRequirements();
  vk::MemoryAllocateInfo allocInfo{.allocationSize  = memRequirements.size,
                                   .memoryTypeIndex = findMemoryType(memRequirements.memoryTypeBits, properties)};
  vk::raii::DeviceMemory imageMemory = vk::raii::DeviceMemory(device, allocInfo);
  image.bindMemory(imageMemory, 0);

  return {std::move(image), std::move(imageMemory)};
}
我把宽度、高度、格式、平铺模式、用途和内存属性都做成了参数,因为本教程后续创建的图像在这些方面都会有所不同。
createTextureImage 函数现在可以简化为:
void createTextureImage()
{
  int            texWidth, texHeight, texChannels;
  stbi_uc       *pixels    = stbi_load("textures/texture.jpg", &texWidth, &texHeight, &texChannels, STBI_rgb_alpha);
  vk::DeviceSize imageSize = texWidth * texHeight * 4;

  if (!pixels)
  {
    throw std::runtime_error("failed to load texture image!");
  }

  auto [stagingBuffer, stagingBufferMemory] =
      createBuffer(imageSize, vk::BufferUsageFlagBits::eTransferSrc, vk::MemoryPropertyFlagBits::eHostVisible | vk::MemoryPropertyFlagBits::eHostCoherent);

  void *data = stagingBufferMemory.mapMemory(0, imageSize);
  memcpy(data, pixels, imageSize);
  stagingBufferMemory.unmapMemory();

  stbi_image_free(pixels);

  std::tie(textureImage, textureImageMemory) = createImage(texWidth,
                                                           texHeight,
                                                           vk::Format::eR8G8B8A8Srgb,
                                                           vk::ImageTiling::eOptimal,
                                                           vk::ImageUsageFlagBits::eTransferDst | vk::ImageUsageFlagBits::eSampled,
                                                           vk::MemoryPropertyFlagBits::eDeviceLocal);
}
布局转换
前面提到,Vulkan 中的图像可以处于不同布局,这会影响像素数据在内存中的组织方式。这些布局针对特定操作做了优化——有些适合着色器读取,有些适合作为渲染目标,还有些适合作为传输操作的源或目标。
布局转换是 Vulkan 设计中的关键一环,它让你能显式控制这些内存组织方式。与另一些由驱动自动处理这类转换的图形 API 不同,Vulkan 要求你显式管理它们。这种做法有利于更好地优化性能,因为你能精确地在需要的时间点安排转换,并高效地批量执行操作。
对于我们的纹理图像,需要执行若干次转换: 1. 从初始的未定义布局转换到适合接收数据的布局(传输目标) 2. 从传输目标转换到适合着色器读取的布局,以便片元着色器从中采样
这些转换通过管线屏障完成,它不仅改变图像布局,还确保访问该图像的操作之间有正确的同步。缺少正确的同步,就可能出现竞争条件:着色器在复制操作完成之前就去读取纹理。
我们接下来要写的函数又会涉及记录并执行命令缓冲区,所以现在正好把这部分逻辑提取成一两个辅助函数:
vk::raii::CommandBuffer beginSingleTimeCommands()
{
  vk::CommandBufferAllocateInfo allocInfo{.commandPool = commandPool, .level = vk::CommandBufferLevel::ePrimary, .commandBufferCount = 1};
  vk::raii::CommandBuffer       commandBuffer = std::move(vk::raii::CommandBuffers(device, allocInfo).front());

  vk::CommandBufferBeginInfo beginInfo{.flags = vk::CommandBufferUsageFlagBits::eOneTimeSubmit};
  commandBuffer.begin(beginInfo);

  return std::move(commandBuffer);
}

void endSingleTimeCommands(vk::raii::CommandBuffer &&commandBuffer)
{
  commandBuffer.end();

  vk::SubmitInfo submitInfo{.commandBufferCount = 1, .pCommandBuffers = &*commandBuffer};
  queue.submit(submitInfo, nullptr);
  queue.waitIdle();
}
这两个函数的代码基于 copyBuffer 中已有的代码。
现在可以把该函数简化为:
void copyBuffer(vk::raii::Buffer &srcBuffer, vk::raii::Buffer &dstBuffer, vk::DeviceSize size)
{
  vk::raii::CommandBuffer commandCopyBuffer = beginSingleTimeCommands();
  commandCopyBuffer.copyBuffer(*srcBuffer, *dstBuffer, vk::BufferCopy{.size = size});
  endSingleTimeCommands(std::move(commandCopyBuffer));
}
如果我们现在还在用缓冲区,那就可以写一个函数来记录并执行 copyBufferToImage,把这件事做完;但该命令要求图像先处于正确的布局。
创建一个新函数来处理布局转换:
void transitionImageLayout(vk::raii::CommandBuffer &commandBuffer, const vk::raii::Image &image, vk::ImageLayout oldLayout, vk::ImageLayout newLayout)
{
}
执行布局转换最常见的方式之一是使用 图像内存屏障。
这类管线屏障一般用于同步对资源的访问,例如确保对缓冲区的写入在读取之前完成,但在使用 vk::SharingMode::eExclusive 时,它也可用于转换图像布局和转移队列族所有权。
缓冲区也有对应的 缓冲区内存屏障 来做同样的事。
vk::ImageMemoryBarrier barrier{.oldLayout           = oldLayout,
                               .newLayout           = newLayout,
                               .srcQueueFamilyIndex = vk::QueueFamilyIgnored,
                               .dstQueueFamilyIndex = vk::QueueFamilyIgnored,
                               .image               = image,
                               .subresourceRange    = {.aspectMask = vk::ImageAspectFlagBits::eColor, .levelCount = 1, .layerCount = 1}};
oldLayout 和 newLayout 指定布局转换。
如果你不关心图像的现有内容,可以把 oldLayout 设为 vk::ImageLayout::eUndefined。
如果用该屏障转移队列族所有权,那么 srcQueueFamilyIndex 和 dstQueueFamilyIndex 字段应填队列族的索引。
如果不打算这样做,它们必须设为 vk::QueueFamilyIgnored(不是默认值!)。
image 和 subresourceRange 指定受影响的图像以及图像的具体部分。
我们的图像不是数组,也没有 mipmap 层级,所以只指定一个层级和一个层。
屏障主要用于同步目的,因此你必须指明:涉及该资源的哪些操作必须在屏障之前发生,以及涉及该资源的哪些操作必须等待该屏障。 正确的取值取决于旧布局和新布局,所以我们先确定要用哪些转换,再回头处理这一点。
commandBuffer.pipelineBarrier(sourceStage, destinationStage, {}, {}, {}, barrier);所有类型的管线屏障都用同一个函数提交。
第一个参数指定屏障之前应发生的操作所在的管线阶段。
第二个参数指定将等待该屏障的操作所在的管线阶段。
屏障前后允许指定的管线阶段,取决于你在屏障前后如何使用该资源。
允许的取值列在规范的 这张表中。
例如,如果屏障之后要从统一缓冲区读取,你应指定用途 vk::AccessFlagBits::eUniformRead,并把最早读取该统一缓冲区的着色器作为管线阶段,例如 vk::PipelineStageFlagBits::eFragmentShader。
对这类用途指定非着色器管线阶段没有意义,而且当你指定的管线阶段与用途类型不匹配时,验证层会给出警告。
第三个参数要么是 {},要么是 vk::DependencyFlagBits::eByRegion。
后者把屏障变成按区域的条件。
也就是说,实现可以提前开始读取资源中已经写入完成的那部分内容。
最后三个参数引用三种可用类型的管线屏障数组:内存屏障、缓冲区内存屏障,以及像我们这里使用的图像内存屏障。
把缓冲区复制到图像
在回到 createTextureImage 之前,我们还要再写一个辅助函数:copyBufferToImage:
void copyBufferToImage(vk::raii::CommandBuffer &commandBuffer, const vk::raii::Buffer &buffer, vk::raii::Image &image, uint32_t width, uint32_t height)
{
}
与缓冲区复制一样,你需要指定缓冲区的哪一部分复制到图像的哪一部分。
这通过 vk::BufferImageCopy 结构体完成:
vk::BufferImageCopy region{.bufferOffset      = 0,
                           .bufferRowLength   = 0,
                           .bufferImageHeight = 0,
                           .imageSubresource  = {.aspectMask = vk::ImageAspectFlagBits::eColor, .mipLevel = 0, .baseArrayLayer = 0, .layerCount = 1},
                           .imageOffset       = {0, 0, 0},
                           .imageExtent       = {width, height, 1}};
这些字段大多望文知义。
bufferOffset 指定缓冲区中像素值起始的字节偏移。
bufferRowLength 和 bufferImageHeight 字段指定像素在内存中的排布方式。
例如,图像各行之间可以存在一些填充字节。
两者都填 0 表示像素紧凑排列,就像我们这里这样。
imageSubresource、imageOffset 和 imageExtent 字段指明要把像素复制到图像的哪一部分。
缓冲区到图像的复制操作通过 vk::raii::CommandBuffer::copyBufferToImage 函数入队:
commandBuffer.copyBufferToImage(buffer, image, vk::ImageLayout::eTransferDstOptimal, region);第三个参数指明图像当前使用的布局。
这里假设图像已经转换到最适合复制像素进去的布局。
现在我们把一整块像素复制到整个图像,但也可以传入一个 vk::BufferImageCopy 数组,在一次操作中从该缓冲区向图像执行多次不同的复制。
准备纹理图像
现在所需的工具都齐了,可以完成纹理图像的设置,我们回到 createTextureImage 函数。
在那里我们最后做的一件事是创建纹理图像。
下一步是把暂存缓冲区复制到纹理图像。
这包括两步:
-
把纹理图像转换到
vk::ImageLayout::eTransferDstOptimal -
执行缓冲区到图像的复制操作
用刚创建的函数很容易做到:
vk::raii::CommandBuffer commandBuffer = beginSingleTimeCommands();
transitionImageLayout(commandBuffer, textureImage, vk::ImageLayout::eUndefined, vk::ImageLayout::eTransferDstOptimal);
copyBufferToImage(commandBuffer, stagingBuffer, textureImage, static_cast<uint32_t>(texWidth), static_cast<uint32_t>(texHeight));
图像创建时的布局是 vk::ImageLayout::eUndefined,所以在转换 textureImage 时应把它作为旧布局。
记住,之所以可以这样,是因为执行复制操作之前我们并不关心它的内容。
为了能在着色器中开始从纹理图像采样,还需要最后一次转换,把它准备好供着色器访问。 最后,结束这个一次性命令缓冲区。
transitionImageLayout(commandBuffer, textureImage, vk::ImageLayout::eTransferDstOptimal, vk::ImageLayout::eShaderReadOnlyOptimal);
endSingleTimeCommands(std::move(commandBuffer));
转换屏障的掩码
如果现在启用验证层运行应用,你会看到它抱怨 transitionImageLayout 中的访问掩码和管线阶段无效。
我们还需要根据转换涉及的两个布局来设置它们。
有两种转换需要处理:
-
未定义 → 传输目标:传输写入不需要等待任何东西
-
传输目标 → 着色器读取:着色器读取应等待传输写入,具体是片元着色器中的着色器读取,因为纹理正是在那里使用
这些规则通过下面的访问掩码和管线阶段指定:
vk::PipelineStageFlags sourceStage;
vk::PipelineStageFlags destinationStage;

if (oldLayout == vk::ImageLayout::eUndefined && newLayout == vk::ImageLayout::eTransferDstOptimal)
{
  barrier.srcAccessMask = {};
  barrier.dstAccessMask = vk::AccessFlagBits::eTransferWrite;

  sourceStage      = vk::PipelineStageFlagBits::eTopOfPipe;
  destinationStage = vk::PipelineStageFlagBits::eTransfer;
}
else if (oldLayout == vk::ImageLayout::eTransferDstOptimal && newLayout == vk::ImageLayout::eShaderReadOnlyOptimal)
{
  barrier.srcAccessMask = vk::AccessFlagBits::eTransferWrite;
  barrier.dstAccessMask = vk::AccessFlagBits::eShaderRead;

  sourceStage      = vk::PipelineStageFlagBits::eTransfer;
  destinationStage = vk::PipelineStageFlagBits::eFragmentShader;
}
else
{
  throw std::invalid_argument("unsupported layout transition!");
}
commandBuffer.pipelineBarrier(sourceStage, destinationStage, {}, {}, nullptr, barrier);
正如上面那张表所示,传输写入必须发生在管线的传输阶段。
由于这些写入不必等待任何东西,屏障之前的操作可以指定空访问掩码和尽可能早的管线阶段 vk::PipelineStageFlagBits::eTopOfPipe。
需要注意,vk::PipelineStageFlagBits::eTransfer 并不是图形与计算管线中 真正 的阶段。
它更像是一个发生传输的伪阶段。
更多信息以及其他伪阶段的例子见 文档。
图像会在同一管线阶段中被写入,随后由片元着色器读取,这也是我们在片元着色器管线阶段指定着色器读取访问的原因。
如果以后还需要更多转换,我们会扩展这个函数。 应用现在应该能成功运行,不过当然还看不到任何视觉变化。
需要说明一点:提交命令缓冲区会在开始时产生隐式的 vk::AccessFlagBits::eHostWrite 同步。
由于 transitionImageLayout 执行的命令缓冲区只包含一条命令,如果你在布局转换中确实需要 vk::AccessFlagBits::eHostWrite 依赖,可以利用这个隐式同步,把 srcAccessMask 设为 0。
是否显式写出来由你决定,不过我个人并不喜欢依赖这类类似 OpenGL 的“隐藏”操作。
其实还有一种支持所有操作的图像布局:vk::ImageLayout::eGeneral。
但除非使用某些扩展(本教程不使用),否则通用布局可能带来性能损失,因为它在某些 GPU 上会禁用一些优化。
有些特殊场景必须用它,例如把图像同时用作输入和输出,或者在图像离开预初始化布局后读取它。
现在图像里已经装好纹理,但我们还需要一种从图形管线访问它的方式。 这将在 下一章中处理。
C++ 代码 / slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器