void initVulkan()
{
    ...
    createUniformBuffers();
    createDescriptorPool();
    ...
}

...

void createDescriptorPool()
{
}简介
上一章介绍过的描述符集布局,描述的是可以绑定的描述符类型。
本章我们会为每一个 vk::raii::Buffer 资源创建一个描述符集,把它绑定到统一缓冲区描述符上。
描述符池
描述符集不能直接创建,必须像命令缓冲区那样从池中分配。
描述符集对应的池不出意外地叫做描述符池。
我们会新写一个函数 createDescriptorPool 来完成这项设置。
首先要用 vk::DescriptorPoolSize 结构说明描述符集将包含哪些描述符类型、各有多少个。
vk::DescriptorPoolSize poolSize{ .type = vk::DescriptorType::eUniformBuffer, .descriptorCount = MAX_FRAMES_IN_FLIGHT };每帧我们会分配其中一个描述符。
这个池大小结构会被主结构 vk::DescriptorPoolCreateInfo 引用:
vk::DescriptorPoolCreateInfo poolInfo{ .flags = vk::DescriptorPoolCreateFlagBits::eFreeDescriptorSet, .maxSets = MAX_FRAMES_IN_FLIGHT, .poolSizeCount = 1, .pPoolSizes = &poolSize };除了单个描述符可用的最大数量,我们还需要指定最多可以分配多少个描述符集。
这个结构还有一个类似命令池的可选标志,用来决定单个描述符集能否被释放。
由于 vk::raii::DescriptorSets 析构时会销毁底层的 vk::DescriptorSet,我们必须把它设为 vk::DescriptorPoolCreateFlagBits::eFreeDescriptorSet,以允许这种释放。
vk::raii::DescriptorPool descriptorPool = nullptr;

...

descriptorPool = vk::raii::DescriptorPool(device, poolInfo);
新增一个类成员来保存描述符池的句柄,并调用 vk::raii::DescriptorPool 构造函数创建它。
描述符集
现在可以分配描述符集本身了。
为此新增一个 createDescriptorSets 函数:
void initVulkan()
{
    ...
    createDescriptorPool();
    createDescriptorSets();
    ...
}

...

void createDescriptorSets()
{
}
描述符集的分配用 vk::DescriptorSetAllocateInfo 结构描述。
你需要指定:从哪个描述符池分配、分配多少个描述符集,以及它们基于哪个描述符集布局:
std::vector<vk::DescriptorSetLayout> layouts(MAX_FRAMES_IN_FLIGHT, *descriptorSetLayout);
vk::DescriptorSetAllocateInfo        allocInfo{.descriptorPool     = descriptorPool,
                                               .descriptorSetCount = static_cast<uint32_t>(layouts.size()),
                                               .pSetLayouts        = layouts.data()};
在本例中,我们会为每个在途帧创建一个描述符集,它们的布局都相同。 遗憾的是,我们确实需要布局的多份副本,因为接下来的函数要求传入与描述符集数量相匹配的数组。
新增一个类成员来保存这些描述符集句柄,并用 vk::raii::Device::allocateDescriptorSets 分配它们:
vk::raii::DescriptorPool             descriptorPool = nullptr;
std::vector<vk::raii::DescriptorSet> descriptorSets;

...

descriptorSets = device.allocateDescriptorSets(allocInfo);
描述符集现在已经分配好了,但里面的描述符还需要配置。 接下来加一个循环,逐个填写每个描述符:
for (size_t i = 0; i < MAX_FRAMES_IN_FLIGHT; i++)
{
}
引用缓冲区的描述符——比如我们的统一缓冲区描述符——用 vk::DescriptorBufferInfo 结构配置。
这个结构指定缓冲区本身,以及其中存放该描述符数据的那一段区域。
for (size_t i = 0; i < MAX_FRAMES_IN_FLIGHT; i++)
{
    vk::DescriptorBufferInfo bufferInfo{ .buffer = uniformBuffers[i], .offset = 0, .range = sizeof(UniformBufferObject) };
}
如果你像本例这样要覆盖整个缓冲区,那么范围也可以直接填 vk::WholeSize。
描述符的配置通过 vk::raii::Device::updateDescriptorSets 函数更新,它的参数是一组 vk::WriteDescriptorSet 结构。
vk::DescriptorBufferInfo bufferInfo{.buffer = uniformBuffers[i], .offset = 0, .range = sizeof(UniformBufferObject)};
vk::WriteDescriptorSet   descriptorWrite{.dstSet          = descriptorSets[i],
                                         .dstBinding      = 0,
                                         .dstArrayElement = 0,
                                         .descriptorCount = 1,
                                         .descriptorType  = vk::DescriptorType::eUniformBuffer,
                                         .pBufferInfo     = &bufferInfo};
前两个字段指定要更新的描述符集和绑定位置。
我们给统一缓冲区的绑定索引是 0。
记住描述符可以是数组,所以还需要指定要更新的数组起始索引。
这里没有使用数组,索引就是 0。
我们还需要再指定一次描述符类型。
可以一次性更新数组中的多个描述符,从索引 dstArrayElement 开始。
descriptorCount 字段指定要更新多少个数组元素。
最后一个字段引用一个数组,其中含有 descriptorCount 个真正用于配置描述符的结构。
具体要用这三个字段中的哪一个,取决于描述符类型。
pBufferInfo 用于引用缓冲区数据的描述符。
这个结构里还有本示例用不到的成员:pImageInfo 用于引用图像数据的描述符,pTexelBufferView 用于引用缓冲区视图的描述符。
我们的描述符基于缓冲区,所以只用 pBufferInfo。
device.updateDescriptorSets(descriptorWrite, {});这些更新通过 vk::raii::Device::updateDescriptorSets 生效。
它接受两个数组参数:一个 vk::WriteDescriptorSet 数组和一个 vk::CopyDescriptorSet 数组。
顾名思义,后者可以把描述符复制到彼此身上。
使用描述符集
现在需要修改 recordCommandBuffer 函数,用 vk::raii::CommandBuffer::bindDescriptorSets 把每一帧对应的描述符集真正绑定到着色器中的描述符上。
这一步必须在调用 vk::raii::CommandBuffer::drawIndexed 之前完成:
commandBuffers[frameIndex].bindDescriptorSets(vk::PipelineBindPoint::eGraphics, pipelineLayout, 0, *descriptorSets[frameIndex], nullptr);
commandBuffer.drawIndexed(static_cast<uint32_t>(indices.size()), 1, 0, 0, 0);
与顶点缓冲区和索引缓冲区不同,描述符集并非图形管线专属。 因此需要指明我们要把描述符集绑定到图形管线还是计算管线。 下一个参数是这些描述符所基于的布局。 再接下来的两个参数分别指定第一个描述符集的索引,以及要绑定的描述符集数组。 这一点稍后还会回头来讲。 最后一个参数指定用于动态描述符的偏移量数组。 这些会在后面的章节里介绍。
如果现在运行程序,你会遗憾地发现屏幕上什么都没有。
原因是我们对投影矩阵做了 Y 轴翻转,顶点现在按逆时针顺序绘制,而不是顺时针。
这触发了背面剔除,导致任何几何体都画不出来。
打开 createGraphicsPipeline 函数,修改 vk::PipelineRasterizationStateCreateInfo 里的 frontFace 来修正:
vk::PipelineRasterizationStateCreateInfo rasterizer{.depthClampEnable        = vk::False,
                                                    .rasterizerDiscardEnable = vk::False,
                                                    .polygonMode             = vk::PolygonMode::eFill,
                                                    .cullMode                = vk::CullModeFlagBits::eBack,
                                                    .frontFace               = vk::FrontFace::eCounterClockwise,
                                                    .depthBiasEnable         = vk::False,
                                                    .lineWidth               = 1.0f};
再次运行程序,你应该会看到:
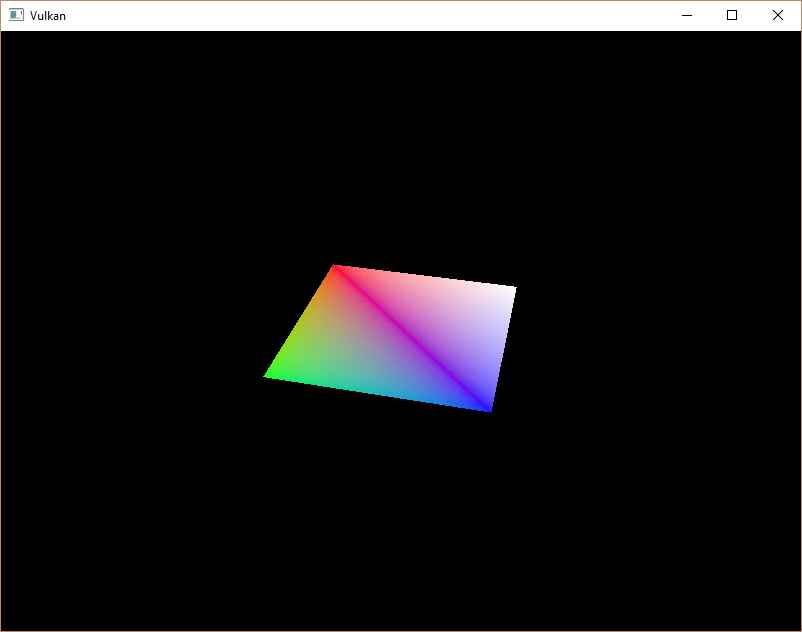
矩形变成了正方形,因为投影矩阵现在会做宽高比修正。
屏幕尺寸变化由 updateUniformBuffer 负责处理,所以我们不需要在 recreateSwapChain 里重建描述符集。
对齐要求
到目前为止,我们一直略过了一点:C++ 结构里的数据究竟该怎样与着色器中的 uniform 定义对应。 看起来只要两边用相同的类型就够了:
struct UniformBufferObject
{
    glm::mat4 model;
    glm::mat4 view;
    glm::mat4 proj;
};

struct UniformBuffer
{
    float4x4 model;
    float4x4 view;
    float4x4 proj;
};
ConstantBuffer<UniformBuffer> ubo;
但事情没这么简单。 例如,试着把结构体和着色器改成这样:
struct UniformBufferObject
{
    glm::vec2 foo;
    glm::mat4 model;
    glm::mat4 view;
    glm::mat4 proj;
};

struct UniformBuffer {
    float2 foo;
    float4x4 model;
    float4x4 view;
    float4x4 proj;
};
ConstantBuffer<UniformBuffer> ubo;
重新编译着色器和程序并运行,你会发现到目前为止辛辛苦苦画出的彩色方块不见了! 这是因为我们还没考虑对齐要求。
Vulkan 要求结构中的数据按特定方式在内存中对齐,例如:
-
标量必须按 N 对齐(对 32 位浮点数来说就是 4 字节)。
-
float2必须按 2N 对齐(= 8 字节) -
float3或float4必须按 4N 对齐(= 16 字节) -
嵌套结构必须按其成员的基础对齐向上取整到 16 的倍数来对齐。
-
float4x4矩阵的对齐方式必须与float4相同。
完整的对齐要求列表见 规范。
我们最初那个只有三个 mat4 字段的着色器本来就满足对齐要求。
每个 mat4 大小为 4 x 4 x 4 = 64 字节,所以 model 的偏移是 0,view 的偏移是 64,proj 的偏移是 128。
这些都是 16 的倍数,因此一切正常。
新结构以一个只有 8 字节的 vec2 开头,于是把所有偏移都带偏了。
现在 model 的偏移是 8,view 是 72,proj 是 136,没有一个是 16 的倍数。
要解决这个问题,可以用 C++11 引入的 alignas 说明符:
struct UniformBufferObject
{
    glm::vec2 foo;
    alignas(16) glm::mat4 model;
    glm::mat4 view;
    glm::mat4 proj;
};
如果现在重新编译并运行程序,应该能看到着色器又正确收到了矩阵值。
好在有一种办法,能让大多数情况下都不必操心这些对齐要求。
可以在包含 GLM 之前定义 GLM_FORCE_DEFAULT_ALIGNED_GENTYPES:
#define GLM_FORCE_DEFAULT_ALIGNED_GENTYPES
#include <glm/glm.hpp>
这会强制 GLM 使用已经替我们指定好对齐要求的 vec2 和 mat4 版本。
加上这个定义之后,就可以去掉 alignas 说明符,程序应当仍能正常工作。
遗憾的是,一旦开始使用嵌套结构,这种做法就会失效。 看看下面这个 C++ 代码里的定义:
struct Foo
{
    glm::vec2 v;
};

struct UniformBufferObject
{
    Foo f1;
    Foo f2;
};
以及下面这个着色器定义:
struct Foo
{
    vec2 v;
};

struct UniformBuffer
{
    Foo f1;
    Foo f2;
};
ConstantBuffer<UniformBuffer> ubo;
在这种情况下 f2 的偏移会是 8,但它是嵌套结构,偏移本应是 16。
此时你必须自己指定对齐:
struct UniformBufferObject
{
    Foo f1;
    alignas(16) Foo f2;
};
这些坑正是“永远显式写明对齐”的充分理由。 这样你就不会被对齐错误那些古怪的症状搞得莫名其妙。
struct UniformBufferObject
{
    alignas(16) glm::mat4 model;
    alignas(16) glm::mat4 view;
    alignas(16) glm::mat4 proj;
};
去掉 foo 字段后,记得重新编译着色器。
多个描述符集
正如一些结构和函数调用所暗示的,其实可以同时绑定多个描述符集。 创建管线布局时,需要为每个描述符集指定一个描述符集布局。 之后着色器就可以这样引用特定的描述符集:
struct UniformBuffer
{
};
ConstantBuffer<UniformBuffer> ubo;
利用这个特性,可以把随对象变化的描述符和共享的描述符放进不同的描述符集。 这样在多次绘制调用之间就不必重新绑定大部分描述符,效率可能更高。
在 接下来的章节里,我们会在刚学内容的基础上给场景添加纹理。
C++ 代码 / slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器