void initVulkan()
{
    createInstance();
    setupDebugMessenger();
    createSurface();
    pickPhysicalDevice();
    createLogicalDevice();
    createSwapChain();
    createImageViews();
    createGraphicsPipeline();
    createCommandPool();
    createVertexBuffer();
    createCommandBuffers();
    createSyncObjects();
}

...

void createVertexBuffer()
{
}引言
Vulkan 中的缓冲区(buffer)是用于存放任意数据的内存区域,显卡可以读取其中的内容。 它们能存放顶点数据,本章就会这样做,但它们还能用于许多其他用途,后续章节会逐一探索。 与前面接触过的 Vulkan 对象不同,缓冲区不会自动为自己分配内存。 前几章的实践已经表明,Vulkan API 几乎把所有事情的控制权都交给程序员,内存管理就是其中之一。
创建缓冲区
新建 createVertexBuffer 函数,并在 initVulkan 中紧挨着 createCommandBuffers 之前调用它。
创建缓冲区需要填写一个 vk::BufferCreateInfo 结构体。
vk::BufferCreateInfo bufferInfo{.size        = sizeof(vertices[0]) * vertices.size(),
                                .usage       = vk::BufferUsageFlagBits::eVertexBuffer,
                                .sharingMode = vk::SharingMode::eExclusive};
size 字段指定缓冲区的大小,单位为字节。用 sizeof 计算顶点数据的字节数很直接。
usage 字段表明缓冲区中的数据将用于哪些目的。多个用途可以用按位或组合起来。我们的用途是顶点缓冲区,其他用法会在后续章节介绍。
和交换链中的图像一样,缓冲区也可以归某个特定队列族所有,或在多个队列族之间共享。 这个缓冲区只会由图形队列使用,所以保持独占访问即可。
还有一个 flags 字段,用于配置稀疏(sparse)缓冲区内存。眼下用不到,就保持默认值 0。
现在可以用 vk::raii::Buffer 构造函数创建缓冲区。
定义一个类成员来保存缓冲区句柄,命名为 vertexBuffer。
vk::raii::Buffer vertexBuffer = nullptr;

...

void createVertexBuffer() {
		vk::BufferCreateInfo bufferInfo{.size        = sizeof(vertices[0]) * vertices.size(),
		                                .usage       = vk::BufferUsageFlagBits::eVertexBuffer,
		                                .sharingMode = vk::SharingMode::eExclusive};
    vertexBuffer = vk::raii::Buffer(device, bufferInfo);
}
这个缓冲区应该一直可用于渲染命令,直到程序结束,而且它不依赖交换链。
内存需求
缓冲区已经创建好了,但还没有为它分配任何内存。
给缓冲区分配内存的第一步,是用名字很贴切的 vk::raii::Buffer::getMemoryRequirements 函数查询它的内存需求。
vk::MemoryRequirements memRequirements = vertexBuffer.getMemoryRequirements();vk::MemoryRequirements 结构体有三个字段:
-
size:所需内存的字节数,可能与bufferInfo.size不同。 -
alignment:缓冲区在已分配内存区域中的起始偏移(字节),取决于bufferInfo.usage和bufferInfo.flags。 -
memoryTypeBits:适合该缓冲区的内存类型的位字段。
显卡可以提供多种类型的内存供分配。
每种内存在允许的操作和性能特征上各不相同。
我们需要把缓冲区的要求和应用自身的要求结合起来,才能选出合适的内存类型。
为此新建一个函数 findMemoryType。
uint32_t findMemoryType(uint32_t typeFilter, vk::MemoryPropertyFlags properties) {

}
首先用 vk::raii::PhysicalDevice::getMemoryProperties 查询可用内存类型的信息。
vk::PhysicalDeviceMemoryProperties memProperties = physicalDevice.getMemoryProperties();vk::PhysicalDeviceMemoryProperties 结构体有两个数组:memoryTypes 和 memoryHeaps。
内存堆(memory heap)是彼此独立的内存资源,比如独占的 VRAM,以及 VRAM 用尽时位于 RAM 中的交换空间。
不同的内存类型就分布在这些堆之中。
眼下我们只关心内存类型,不关心它来自哪个堆,但可以想象,堆的选择会影响性能。
先来找一个适合缓冲区本身的内存类型:
for (uint32_t i = 0; i < memProperties.memoryTypeCount; i++)
{
    if ((typeFilter & (1 << i)))
    {
        return i;
    }
}

throw std::runtime_error("failed to find suitable memory type!");
typeFilter 参数用来指明合适内存类型的位字段。
也就是说,只要遍历所有类型,检查对应的位是否为 1,就能得到合适内存类型的索引。
不过,我们需要的不仅是适合顶点缓冲区的内存类型,还得能往这块内存里写入顶点数据。
memoryTypes 数组由 vk::MemoryType 结构体组成,它描述每种内存类型所属的堆及其属性。
属性定义了内存的特殊能力,比如能否映射,好让我们从 CPU 写入。
这项能力由 vk::MemoryPropertyFlagBits::eHostVisible 表示,但我们还需要 vk::MemoryPropertyFlagBits::eHostCoherent 属性。
等到映射内存时就会明白原因。
现在修改循环,让它同时检查是否支持这些属性:
for (uint32_t i = 0; i < memProperties.memoryTypeCount; i++)
{
    if ((typeFilter & (1 << i)) && (memProperties.memoryTypes[i].propertyFlags & properties) == properties)
    {
        return i;
    }
}
我们希望具备的属性可能不止一个,所以检查按位与的结果时不能只看非零,而要看它是否等于期望的属性位字段。 如果存在既适合缓冲区、又具备全部所需属性的内存类型,就返回它的索引,否则抛出异常。
分配内存
现在有了确定合适内存类型的办法,就可以填写 vk::MemoryAllocateInfo 结构体,真正分配内存了。
vk::MemoryAllocateInfo memoryAllocateInfo{
    .allocationSize  = memRequirements.size,
    .memoryTypeIndex = findMemoryType(memRequirements.memoryTypeBits, vk::MemoryPropertyFlagBits::eHostVisible | vk::MemoryPropertyFlagBits::eHostCoherent)};
现在分配内存只需指定大小和类型,两者都来自顶点缓冲区的内存需求和期望的属性。
新增一个类成员保存内存句柄,并用 vk::raii::DeviceMemory 构造函数完成分配。
vk::raii::Buffer       vertexBuffer       = nullptr;
vk::raii::DeviceMemory vertexBufferMemory = nullptr;

...

vertexBufferMemory = vk::raii::DeviceMemory(device, memoryAllocateInfo);
内存分配成功后,就可以用 vk::raii::Buffer::bindBufferMemory 把这块内存与缓冲区关联起来:
vertexBuffer.bindMemory( *vertexBufferMemory, 0 );第一个参数不言自明,第二个参数是这块内存区域内的偏移。
由于内存是专为这个顶点缓冲区分配的,偏移直接写 0。
如果偏移不为零,它必须能被 memRequirements.alignment 整除。
填充顶点缓冲区
接下来该把顶点数据复制到缓冲区了。
具体做法是用 vk::raii::DeviceMemory::mapMemory 把缓冲区内存 映射 到 CPU 可访问的内存中。
void* data = vertexBufferMemory.mapMemory(0, bufferInfo.size);这个函数让我们能访问指定内存资源中由偏移和大小划出的一块区域。
这里的偏移和大小分别是 0 和 bufferInfo.size。
void* data = vertexBufferMemory.mapMemory(0, bufferInfo.size);
memcpy(data, vertices.data(), bufferInfo.size);
vertexBufferMemory.unmapMemory();
现在只要把顶点数据 memcpy 到映射内存,再用 vk::raii::DeviceMemory::unmapMemory 解除映射即可。
遗憾的是,驱动未必会立刻把数据复制进缓冲区内存,比如可能因为缓存。
也有可能出现写入缓冲区的数据在映射内存中还不可见的情况。
有两种办法可以应对:
-
使用主机一致(host coherent)的内存堆,由
vk::MemoryPropertyFlagBits::eHostCoherent指示 -
写入映射内存后调用
vk::raii::Device::flushMappedMemoryRanges,从映射内存读取之前调用vk::raii::Device::invalidateMappedMemoryRanges
我们采用了第一种做法,它能保证映射内存始终与已分配内存的内容一致。 要记住,相比显式刷新,这样做性能可能略差,但下一章会说明为什么这无关紧要。
刷新内存范围或使用一致的内存堆,只是让驱动知道我们向缓冲区写入了数据,并不意味着这些数据已经真正在 GPU 上可见。
把数据传输到 GPU 是在后台进行的操作,规范只是 告诉我们,它保证在下一次调用 vk::raii::Queue::submit 时完成。
绑定顶点缓冲区
剩下的就是在渲染时绑定顶点缓冲区。
我们扩展 recordCommandBuffer 函数来完成这件事。
commandBuffer.bindPipeline(vk::PipelineBindPoint::eGraphics, *graphicsPipeline);

commandBuffer.bindVertexBuffers(0, *vertexBuffer, {0});

commandBuffer.draw(static_cast<uint32_t>(vertices.size()), 1, 0, 0);
vk::raii::CommandBuffer::bindVertexBuffers 函数用于把顶点缓冲区绑定到绑定位置,也就是上一章建立的那个。
第一个参数是绑定位置的偏移。
第二个参数是待绑定缓冲区的数组。
最后一个参数是同样长度的字节偏移数组,指明从何处开始读取顶点数据。
此外还要修改 vk::CommandBuffer::draw 的调用,传入缓冲区中的顶点数,而不是硬编码的数字 3。
现在运行程序,应该又能看到熟悉的三角形:
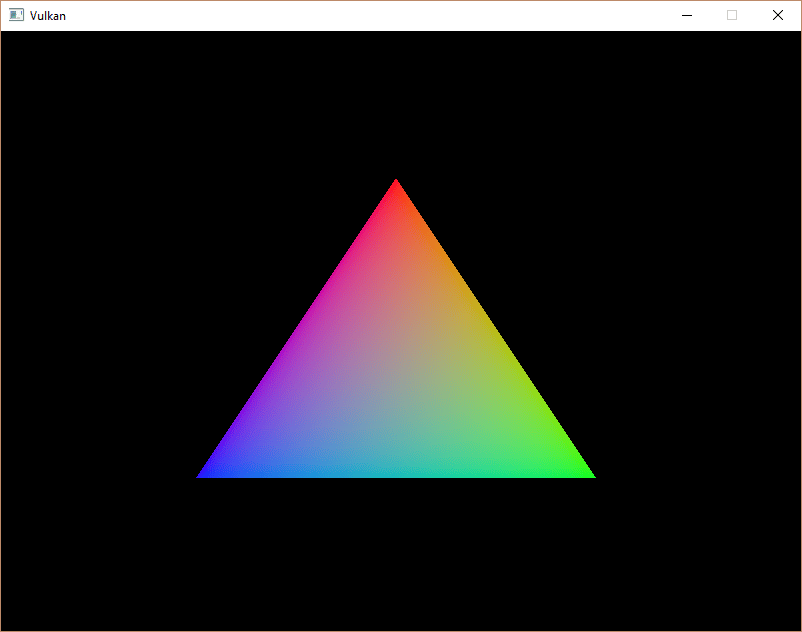
试着修改 vertices 数组,把顶部顶点的颜色改成白色:
const std::vector<Vertex> vertices = {
    {{0.0f, -0.5f}, {1.0f, 1.0f, 1.0f}},
    {{0.5f, 0.5f}, {0.0f, 1.0f, 0.0f}},
    {{-0.5f, 0.5f}, {0.0f, 0.0f, 1.0f}}
};
再次运行程序,会看到下面的结果:
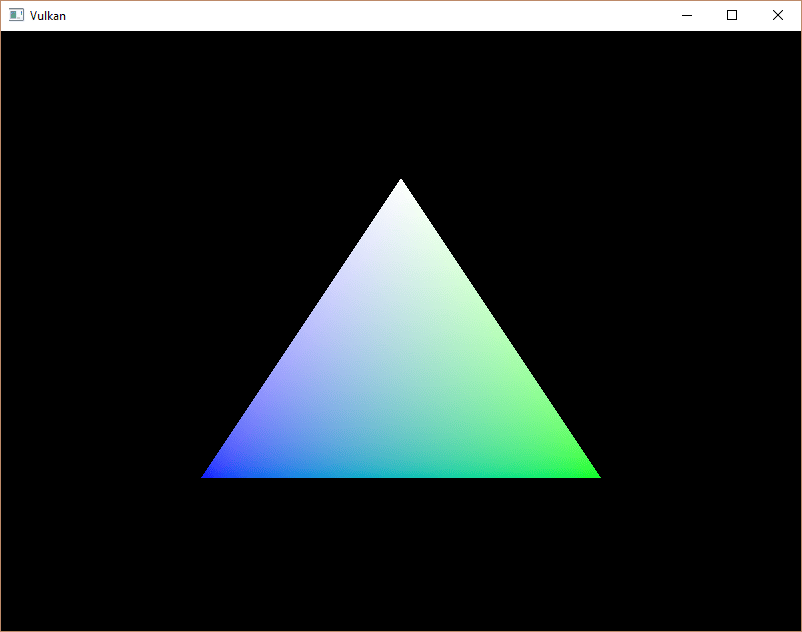
在 下一章 中,我们会介绍另一种把顶点数据复制到顶点缓冲区的办法,它性能更好,但要多费些功夫。
C++ 代码 / Slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器