void mainLoop()
{
    while (!glfwWindowShouldClose(window)) {
        glfwPollEvents();
        drawFrame();
    }
}

...

void drawFrame()
{
}本章会把此前所有内容串到一起。
我们要编写 drawFrame 函数,由主循环调用它把三角形送上屏幕。
先创建这个函数,并在 mainLoop 里调用:
一帧的流程
从高层来看,用 Vulkan 渲染一帧包含一组固定的步骤:
-
等待上一帧结束
-
从交换链获取一张图像
-
录制命令缓冲区,把场景绘制到这张图像上
-
提交录制好的命令缓冲区
-
呈现交换链图像
后面几章会扩展绘制函数,但目前这已经是渲染循环的核心。
同步
Vulkan 的一条核心设计理念是:GPU 上的执行同步必须是显式的。 操作顺序由我们自己用各种同步原语来定义,以此告诉驱动我们希望这些工作按什么顺序运行。 这意味着许多会在 GPU 上启动工作的 Vulkan API 调用都是异步的,函数在操作完成之前就会返回。
本章有几件事发生在 GPU 上,需要由我们显式安排顺序,例如:
-
从交换链获取一张图像
-
执行把内容绘制到所获取图像上的命令
-
把这张图像呈现到屏幕,也就是交还给交换链
这些事件各自只由一次函数调用发起,但全部异步执行。 函数在操作真正完成之前就返回,执行顺序也没有定义。 这可不妙,因为每个操作都依赖前一个操作完成。 因此我们需要研究,可以用哪些原语来实现想要的顺序。
信号量
二值信号量(binary semaphore)用来在队列操作之间建立顺序。 队列操作指的是我们提交给队列的工作,它可以写在命令缓冲区里,也可以像后面会看到的那样直接在函数中提交。 队列的例子有图形队列和呈现队列。 信号量既能为同一队列内部的工作排序,也能在不同队列之间排序。
Vulkan 中恰好有两种信号量:二值信号量和时间线信号量(timeline semaphore)。 本教程只使用二值信号量,所以不讨论时间线信号量。 后文再提到“信号量”时,一律指二值信号量。
二值信号量只有未发出信号(unsignaled)和已发出信号(signaled)两种状态,创建时处于未发出信号状态。 我们用它来安排队列操作顺序的方式是:把同一个信号量在一个队列操作中当作“发出信号”的信号量,在另一个队列操作中当作“等待”的信号量。 举例来说,假设有信号量 S,以及想按顺序执行的队列操作 A 和 B。 我们告诉 Vulkan:操作 A 执行完毕后“发出”信号量 S,操作 B 开始执行前“等待”信号量 S。 操作 A 完成后,信号量 S 被发出信号;而操作 B 要等到 S 发出信号才会开始。 操作 B 开始执行后,信号量 S 会自动重置回未发出信号状态,从而可以再次使用。
上面描述的过程用伪代码表示如下:
vk::raii::CommandBuffer A, B = ... // 录制命令缓冲区
vk::raii::Semaphore S = ...        // 创建信号量

// 将 A 入队,完成后发出信号量 S——立即开始执行
queue.submit(work: A, signal: S, wait: None)

// 将 B 入队,等待 S 后再开始
queue.submit(work: B, signal: None, wait: S)
注意,这段代码里两次 queue.submit() 调用都会立刻返回——等待只发生在 GPU 上。
CPU 会继续运行,不会被阻塞。
若要 CPU 也等待,就需要另一种同步原语,下面就来介绍。
栅栏
栅栏(fence)的用途类似,同样用于同步执行,但它安排的是 CPU(也就是主机,host)一侧的执行顺序。 具体来说,如果主机需要知道 GPU 何时完成了某项工作,就要使用栅栏。
与信号量类似,栅栏也只有已发出信号和未发出信号两种状态。 每次提交工作执行时,都可以给这份工作附上一个栅栏。 工作完成后,栅栏会被发出信号。 随后我们可以让主机等待栅栏发出信号,从而保证工作在主机继续执行之前已经完成。
一个具体例子是截图。 假设 GPU 上必要的工作已经完成。 现在需要把图像从 GPU 传输回主机,再把内存内容保存成文件。 我们有负责执行这次传输的命令缓冲区 A 和栅栏 F。 提交命令缓冲区 A 时一并附上栅栏 F,然后立刻让主机等待 F 发出信号。 这会让主机阻塞,直到命令缓冲区 A 执行完毕。 既然内存传输已经完成,主机再把文件写入磁盘就是安全的。
上述过程用伪代码表示:
vk::raii::CommandBuffer A = ... // 录制包含传输操作的命令缓冲区
vk::raii::Fence F = ...         // 创建栅栏

// 将 A 入队,立即开始工作,完成后发出栅栏 F
queue.submit(work: A, fence: F)

device.waitForFences(F) // 阻塞执行,直到 A 执行完毕

save_screenshot_to_disk() // 传输完成后才能运行
与信号量的例子不同,这个例子确实会阻塞主机的执行。 也就是说,主机除了等待执行结束,什么也做不了。 在这个场景中,必须先确保传输完成,才能把截图写入磁盘。
一般来说,除非必要,最好不要阻塞主机。 我们希望让 GPU 和主机都有有用的活可干。 等待栅栏发出信号算不上有用的活。 因此同步工作时,我们更倾向于使用信号量,或者尚未介绍的其他同步原语。
栅栏必须手动重置,才能回到未发出信号状态。 这是因为栅栏用于控制主机侧的执行,何时重置自然该由主机决定。 相比之下,信号量用于在 GPU 上安排工作顺序,主机并不参与。
总结一下:信号量用来规定 GPU 上各操作的执行顺序,栅栏用来让 CPU 与 GPU 彼此保持同步。
该选哪一个?
我们有两种同步原语可用,而需要同步的地方恰好也有两处:交换链操作,以及等待上一帧结束。 交换链操作发生在 GPU 上,所以这里要用信号量;只要有可能,我们就不想让主机干等。 等待上一帧结束则相反,这里要用栅栏,因为我们需要主机真正等待。 这样才能保证同一时间不会绘制超过一帧。 由于每帧都要重新录制命令缓冲区,在当前帧执行完毕之前,我们不能把下一帧的工作录进去。 总不能在 GPU 还在使用命令缓冲区时覆盖它的内容。
创建同步对象
我们需要一个信号量,用来表示已从交换链获取到图像、可以开始渲染。 还需要一个信号量表示渲染已完成、可以呈现,以及一个栅栏,确保同一时间只渲染一帧。
创建三个类成员来保存这两个信号量对象和这个栅栏对象:
vk::raii::Semaphore presentCompleteSemaphore = nullptr;
vk::raii::Semaphore renderFinishedSemaphore  = nullptr;
vk::raii::Fence     drawFence                = nullptr;
为了创建这些信号量,我们加上本部分教程最后一个 create 函数:createSyncObjects:
void initVulkan()
{
    createInstance();
    setupDebugMessenger();
    createSurface();
    pickPhysicalDevice();
    createLogicalDevice();
    createSwapChain();
    createImageViews();
    createGraphicsPipeline();
    createCommandPool();
    createCommandBuffer();
    createSyncObjects();
}

...

void createSyncObjects()
{
}
创建信号量需要填写 vk::SemaphoreCreateInfo,不过在当前的 API 版本中,它实际上没有任何与本教程相关的字段:
void createSyncObjects()
{
  presentCompleteSemaphore = vk::raii::Semaphore(device, vk::SemaphoreCreateInfo());
  renderFinishedSemaphore  = vk::raii::Semaphore(device, vk::SemaphoreCreateInfo());
  drawFence                = vk::raii::Fence(device, {.flags = vk::FenceCreateFlagBits::eSignaled});
}
未来的 Vulkan API 版本或扩展可能会像对待其他结构体那样,为 vk::SemaphoreCreateInfo 的 flags 和 pNext 成员增加功能。
接下来进入主要的绘制函数!
等待上一帧
每帧开始时,我们要等到上一帧结束,这样命令缓冲区和信号量才可用。
为此调用 vk::raii::Device::waitForFences:
void drawFrame()
{
    auto fenceResult = device.waitForFences(*drawFence, vk::True, UINT64_MAX);
		if (fenceResult != vk::Result::eSuccess)
		{
			throw std::runtime_error("failed to wait for fence!");
		}
		device.resetFences(*drawFence);
}
vk::raii::Device::waitForFences 函数接收一个栅栏数组,在主机上等待其中任意一个或全部栅栏发出信号后再返回。
这里传入的 vk::True 表示要等待所有栅栏;不过只有一个栅栏时,这一点无所谓。
该函数还有一个超时参数,我们把它设为 64 位无符号整数的最大值 UINT64_MAX,相当于关闭超时。
如果上一帧已经结束,我们必须确保栅栏已被重置,这样后面才能继续等待它。
接下来,在上一帧结束后从交换链获取一张图像:
void drawFrame()
{
    ...
    auto [result, imageIndex] = swapChain.acquireNextImage(UINT64_MAX, *presentCompleteSemaphore, nullptr);
}
第一个参数指定等待图像变为可用的超时时间,单位为纳秒。 传入 64 位无符号整数的最大值,就相当于关闭超时。
后面两个参数指定同步对象:当呈现引擎用完这张图像时,它们会被发出信号。
从那一刻起,我们才可以开始往这张图像上绘制。
这里可以指定信号量、栅栏,或两者都指定。
本例中用 presentCompleteSemaphore 承担这个角色。
该函数返回一对值:常见的 vk::Result,以及变为可用的交换链图像索引。
这个索引对应 swapChainImages 数组中的 vk::Image。
我们会用它取出相应的交换链图像视图,然后录制渲染到这张图像上的命令。
录制命令缓冲区
拿到了指明所用交换链图像的 imageIndex,现在就可以录制命令缓冲区了。
调用 recordCommandBuffer 函数录制我们需要的命令。
recordCommandBuffer(imageIndex);命令缓冲区录制完整,接下来就可以提交它了。
提交命令缓冲区
队列提交与同步通过 vk::SubmitInfo 结构体中的参数配置。
vk::PipelineStageFlags waitDestinationStageMask( vk::PipelineStageFlagBits::eColorAttachmentOutput );
const vk::SubmitInfo   submitInfo{.waitSemaphoreCount   = 1,
                                  .pWaitSemaphores      = &*presentCompleteSemaphore,
                                  .pWaitDstStageMask    = &waitDestinationStageMask,
                                  .commandBufferCount   = 1,
                                  .pCommandBuffers      = &*commandBuffer,
                                  .signalSemaphoreCount = 1,
                                  .pSignalSemaphores    = &*renderFinishedSemaphore};
前三个参数指定执行开始前要等待哪些信号量,以及要等到管线的哪个(些)阶段。
我们希望等到图像可用之后再写入颜色,所以指定图形管线中写入颜色附件的阶段。
也就是说,理论上实现可以在图像尚未可用时就开始执行顶点着色器之类的阶段。
waitStages 数组中的每一项,对应 pWaitSemaphores 中相同索引的信号量。
下一个参数指定实际要提交执行的命令缓冲区。 我们只提交手头这一个命令缓冲区。
pSignalSemaphores 参数指定命令缓冲区执行完毕后要发出哪些信号量。
这里用的是 renderFinishedSemaphore。
queue.submit(submitInfo, *drawFence);现在可以用 vk::raii::Queue::submit 把命令缓冲区提交到图形队列。
为了在负载大得多时保持效率,该函数接收的是 vk::SubmitInfo 结构体数组。
最后一个参数引用一个可选的栅栏,命令缓冲区执行完毕时它会被发出信号。
这样我们就知道何时可以安全地重用该命令缓冲区,因此传入 *drawFence,并在下一帧中等待它。
呈现
绘制一帧的最后一步,是把结果交回交换链,让它最终出现在屏幕上。
呈现由 drawFrame 函数末尾的 vk::PresentInfoKHR 结构体配置。
const vk::PresentInfoKHR presentInfoKHR{
    .waitSemaphoreCount = 1,
    .pWaitSemaphores    = &*renderFinishedSemaphore,
    .swapchainCount     = 1,
    .pSwapchains        = &*swapChain,
    .pImageIndices      = &imageIndex};
前两个参数指定呈现发生前要等待哪些信号量,和 vk::SubmitInfo 一样。
我们要等命令缓冲区执行完毕,也就是三角形绘制完成,因此取出会被发出信号的信号量来等待,这里就是 renderFinishedSemaphore。
后面两个参数指定要向哪些交换链呈现图像,以及每条交换链所用的图像索引。 这一般都只有一个。
presentInfoKHR.pResults = nullptr; // 可选还有一个可选参数 pResults。
它让你提供一个 vk::Result 数组,逐条检查每个交换链的呈现是否成功。
只使用一条交换链时并不需要它,因为可以直接使用呈现函数的返回值。
result = queue.presentKHR(presentInfoKHR);vk::raii::Queue::presentKHR 函数提交向交换链呈现图像的请求。
我们会在下一章为 vk::raii::SwapchainKHR::acquireNextImage 和 vk::raii::Queue::presentKHR 都加上错误处理,因为它们的失败并不一定意味着程序该终止——这与目前见过的其他函数不同。
如果前面每一步都做对了,现在运行程序应当能看到类似下面的画面:
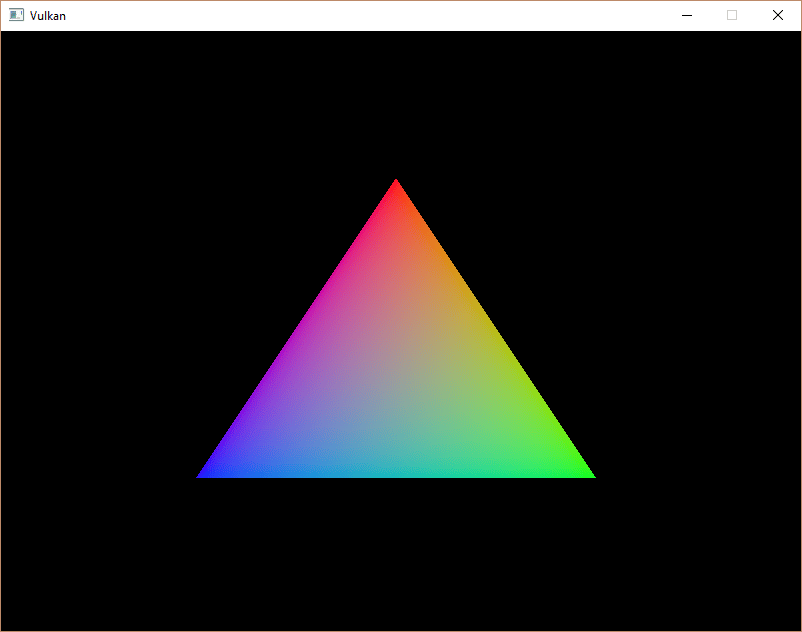
这个彩色三角形看起来可能与你以往在图形教程里见到的略有不同。 原因在于本教程让着色器在线性色彩空间中插值,之后再转换到 sRGB 色彩空间。
太好了!
可惜的是,你会发现启用验证层后,程序一关闭就会崩溃。
debugCallback 打印到终端的消息说明了原因:
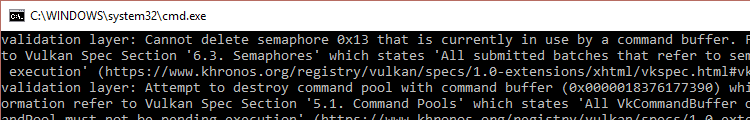
记住 drawFrame 中的所有操作都是异步的。
这意味着退出 mainLoop 的循环时,绘制和呈现操作可能仍在进行。
在这种时候清理资源可不是好主意。
要解决这个问题,应当在退出 mainLoop、销毁窗口之前,等待逻辑设备完成操作:
void mainLoop() {
    while (!glfwWindowShouldClose(window)) {
        glfwPollEvents();
        drawFrame();
    }

    device.waitIdle();
}
也可以用 vk::raii::Queue::waitIdle 等待某个命令队列中的操作完成。
这类函数可以作为最简陋的同步手段。
你会发现,现在关闭窗口时程序可以正常退出了。
小结
五百多行代码之后,我们终于走到了能在屏幕上看到东西的阶段! 引导一个 Vulkan 程序确实费劲,但关键在于:Vulkan 通过显式表达,把极大的控制权交给了你。 建议你现在花点时间重读代码,在脑中建立起模型:程序里每个 Vulkan 对象是做什么的,它们之间又如何关联。 此后我们会在此基础上继续扩展程序的功能。
另外,后续章节还会讲时间线信号量和内存屏障,进一步加深对 Vulkan 同步的理解。 同步正是发挥 Vulkan 真正实力的最大领域之一,因此也相当复杂。 它前几次理解起来确实费劲,但恰恰是后续内容的基础。 等你工具箱里的工具更多、能处理更细微的情况时,从这里往后会轻松不少。
下一章会扩展渲染循环,让它支持多个在途帧。
C++ 代码 / Slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器