与早期 API 不同,Vulkan 中的着色器代码必须以字节码格式给出,而不能像 GLSL、https://shader-slang.org/slang/user-guide/[Slang]、https://en.wikipedia.org/wiki/High-Level_Shading_Language[HLSL] 那样使用人类可读的语法。这种字节码格式称为 SPIR-V,专为配合 Vulkan(一个 Khronos 推出的 API)而设计。它既可以用来编写图形着色器,也可以用来编写计算着色器,但本教程只关注 Vulkan 图形管线中用到的着色器。
使用字节码格式的好处在于,GPU 厂商为把着色器代码转换成原生代码而编写的编译器可以显著简化。过去的经验表明,面对 GLSL 这类人类可读语法,有些 GPU 厂商对标准的解释相当随意。如果你恰好用这些厂商的 GPU 编写了并不简单的着色器,就可能承担另一种风险:别的厂商的驱动因语法错误而拒绝你的代码;更糟的是,由于编译器 bug,你的着色器运行结果与预期不符。改用 SPIR-V 这样直截了当的字节码格式,有望避免这些问题。
不过,这并不意味着我们需要手写这种字节码。Khronos 发布了自己的厂商无关编译器,可以把 Slang 编译成 SPIR-V。这个编译器的设计目标是验证你的着色器代码完全符合标准,并产出可直接随程序发布的单个 SPIR-V 二进制文件。你也可以把它当作库使用,在运行时生成 SPIR-V,但本教程不会这么做,直到将来某一章讲到反射(reflection)时再说。虽然我们可以通过 slangc 直接调用这个编译器,但这里改为在 CMake 构建过程中使用 slangc。
Slang 是一门采用 C 风格语法的着色语言。用它编写的程序有一个主入口点,对每个对象都会调用一次。与 HLSL 一样,Slang 用参数和返回值表达输入输出,并配合注解(annotation)说明这些变量对应什么。这门语言包含许多辅助图形编程的特性,比如内置的向量和矩阵基本类型。它还提供了叉积、矩阵与向量相乘、面向 AI 的自动微分、绕向量做反射等运算函数。向量类型的写法是 float 加上表示元素个数的数字,例如三维位置就存放在 float3 里。
可以通过 .x 这样的成员访问单个分量,这称为 swizzle 运算符;也可以同时用多个分量构造新向量。例如表达式 float3(1.0,2.0, 3.0).xy 的结果是 float2。向量的构造函数还能接受向量对象与标量值的组合,例如一个 float3 可以用 float3(float2(1.0, 2.0), 3.0) 构造出来。
正如上一章所说,要想把一个三角形显示到屏幕上,我们需要编写一个顶点着色器和一个片元着色器。接下来两节会介绍这两段 Slang 代码,然后再演示如何生成 SPIR-V 二进制文件并把它加载到程序中。
顶点着色器
顶点着色器处理每一个传入的顶点。它以顶点的属性为输入,例如世界坐标、颜色、法线和纹理坐标;输出则是裁剪坐标下的最终位置,以及需要传给片元着色器的属性,例如颜色和纹理坐标。随后光栅化器会在各片元之间对这些值做插值,从而产生平滑的渐变。
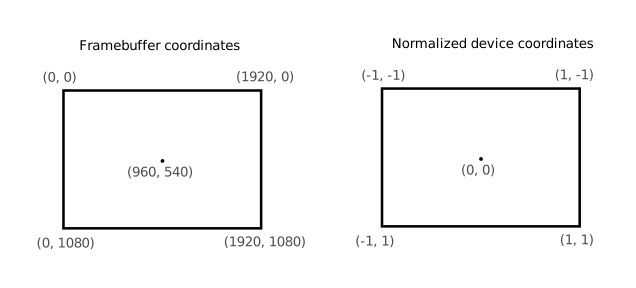
所谓裁剪坐标,是顶点着色器输出的四维向量,把整个向量除以其最后一个分量,就得到标准化设备坐标。这些标准化设备坐标是 齐次坐标,它们把帧缓冲映射到 [-1, 1] × [-1, 1] 的坐标系,如下图所示:
如果你以前接触过计算机图形学,应该已经熟悉这些内容。如果你用过 OpenGL,就会注意到 Y 坐标的符号现在反了过来。Z 坐标的取值范围则与 Direct3D 中相同,是从 0 到 1。
第一个三角形不做任何变换,我们直接把三个顶点的位置以标准化设备坐标的形式给出,从而得到下面的形状:
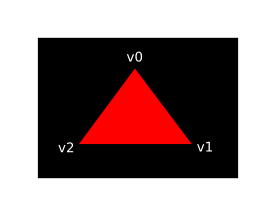
只要在顶点着色器中直接把标准化设备坐标作为裁剪坐标输出,并把最后一个分量设为 1,就能达到这个效果。这样一来,把裁剪坐标转换为标准化设备坐标时所做的除法就不会改变任何值。
通常这些坐标会存放在顶点缓冲区里,但在 Vulkan 中创建顶点缓冲区并填入数据并不简单。因此我决定先跳过这一步,等我们享受过三角形跃然屏上的成就感之后再说。这期间我们采用一个不太常规的做法:把坐标直接写在顶点着色器里。代码如下:
static float2 positions[3] = float2[](
    float2(0.0, -0.5),
    float2(0.5, 0.5),
    float2(-0.5, 0.5)
);

struct VertexOutput {
    float4 sv_position : SV_Position;
};

[shader("vertex")]
VertexOutput vertMain(uint vid : SV_VertexID) {
    VertexOutput output;
    output.sv_position = float4(positions[vid], 0.0, 1.0);
    return output;
}
vertMain 函数对每个顶点调用一次。参数中带有 SV_VertexID 注解的内置变量保存着当前顶点的索引。通常这个索引用于访问顶点缓冲区,但在本例中,它用于访问一个硬编码的顶点数据数组。每个顶点的位置都从着色器里的常量数组中取出,再补上占位的 z 和 w 分量,得到裁剪坐标下的位置。SV_Position 内置注解标记 VertexOutput 结构体中的输出。如果你熟悉 GLSL 或 HLSL 等其他着色语言,有一点值得说明:这里没有任何绑定(binding)指令。这是 Slang 的特性,Slang 会按声明顺序自动推断绑定。存放位置的结构体被声明为 static,用来告诉编译器我们的着色器不需要任何绑定。细心的读者会注意到,我们把主函数命名为 vertMain 而不是 main,这是因为 Slang 和 SPIR-V 都支持在一个文件里包含多个入口点。当你处理的管线不止一个顶点/片元组合时,这一点很重要。以光线追踪为例,即便是简单的演示,也往往有四个甚至更多着色器,每个都很小却各自需要一个文件,管理起来相当麻烦。Slang 的另一大特性是可以创建着色器库或模块;这门特性丰富的着色语言的更多用法,就留给读者自行探索了。
本教程中,我们通过把着色器保持在单个文件里来演示最佳实践。如果你熟悉 GLSL,附件文件夹中也有这些着色器的 GLSL 版本,它们是直接对应的翻译。
片元着色器
顶点着色器给出的位置围成三角形,在屏幕上覆盖一片由片元组成的区域。片元着色器就在这些片元上执行,为帧缓冲(或多个帧缓冲)产生颜色和深度。下面这个简单的片元着色器把整个三角形输出为红色:
[shader("fragment")]
float4 fragMain() : SV_Target
{
    return float4(1.0, 0.0, 0.0, 1.0);
}
fragMain 入口函数会为每个片元调用一次,正如顶点着色器会为每个顶点调用 vertMain 一样。Slang 中的颜色是四分量向量,其 R、G、B 和 alpha 通道都落在 [0, 1] 范围内。返回值上的 SV_Target 注解表示它要作为颜色写入帧缓冲。实际上这个注解在这里是可选的:Slang 会自行根据返回值推断渲染目标,即使一个着色器写入多个帧缓冲也能处理,所以只有当你想把某个输出显式固定到特定帧缓冲索引时,才需要 SV_Target。我们在示例中保留它,是为了让“什么写到哪里”更清楚。红色直接以 float4(1.0, 0.0, 0.0, 1.0) 返回。
逐顶点颜色
整个三角形都是红色未免太单调,换成下面这样是不是好看得多?
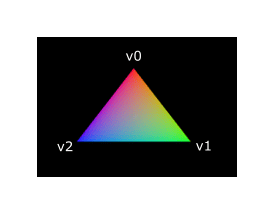
为此需要对两个着色器都做些改动。首先,要为三个顶点分别指定不同的颜色。现在顶点着色器应当像处理位置那样,加上一个颜色数组:
static float3 colors[3] = float3[](
    float3(1.0, 0.0, 0.0),
    float3(0.0, 1.0, 0.0),
    float3(0.0, 0.0, 1.0)
);
接下来只需把这些逐顶点颜色传给片元着色器,让它能把插值后的颜色输出到帧缓冲。在顶点着色器中为颜色添加一个输出,并在 vertMain 函数里给它赋值:
struct VertexOutput {
    float3 color;
    float4 sv_position : SV_Position;
};

[shader("vertex")]
VertexOutput vertMain(uint vid : SV_VertexID) {
    VertexOutput output;
    output.sv_position = float4(positions[vid], 0.0, 1.0);
    output.color = colors[vid];
    return output;
}
然后要在片元着色器中添加一个匹配的参数:
[shader("fragment")]
float4 fragMain(VertexOutput inVert) : SV_Target
{
    float3 color = inVert.color;
    return float4(color, 1.0);
}
输入变量不一定非要同名,但如果两个着色器在同一个文件里,不重复自己确实很方便。不过无论是否同名,它们都会通过 location 指令指定的索引关联起来。fragMain 函数已经改成输出颜色以及 alpha 值。如上图所示,三个顶点之间的片元会自动对 fragColor 的值做插值,形成平滑的渐变。
编译着色器
在项目根目录下创建一个名为 shaders 的目录,把着色器保存到 shader.slang 文件中。
shader.slang 的内容应当是:
static float2 positions[3] = float2[](
    float2(0.0, -0.5),
    float2(0.5, 0.5),
    float2(-0.5, 0.5)
);

static float3 colors[3] = float3[](
    float3(1.0, 0.0, 0.0),
    float3(0.0, 1.0, 0.0),
    float3(0.0, 0.0, 1.0)
);

struct VertexOutput {
    float3 color;
    float4 sv_position : SV_Position;
};

[shader("vertex")]
VertexOutput vertMain(uint vid : SV_VertexID) {
    VertexOutput output;
    output.sv_position = float4(positions[vid], 0.0, 1.0);
    output.color = colors[vid];
    return output;
}

[shader("fragment")]
float4 fragMain(VertexOutput inVert) : SV_Target
{
    float3 color = inVert.color;
    return float4(color, 1.0);
}
接下来我们用 slangc 程序把它们编译成 SPIR-V 字节码。
Windows
创建一个内容如下的 compile.bat 文件:
C:/VulkanSDK/x.x.x.x/bin/slangc.exe shader.slang -target spirv -profile spirv_1_4 -emit-spirv-directly -fvk-use-entrypoint-name -entry vertMain -entry fragMain -o slang.spv把 slangc.exe 的路径换成你安装 Vulkan SDK 的位置。双击该文件运行。
Linux
创建一个内容如下的 compile.sh 文件:
/home/user/VulkanSDK/x.x.x.x/x86_64/bin/slangc shader.slang -target spirv -profile spirv_1_4 -emit-spirv-directly -fvk-use-entrypoint-name -entry vertMain -entry fragMain -o slang.spv把 slangc 的路径换成你安装 Vulkan SDK 的位置。用 chmod +x compile.sh 让脚本可执行,然后运行它。
平台相关说明结束
这两条命令让编译器读取 Slang 源文件,并通过 -o(输出)标志直接输出 SPIR-V 1.4 字节码文件。
注意:SlangC 原生支持 SPIR-V 1.3 及以上版本,无需先生成 GLSL 再转成 SPIR-V。本教程中的内容虽然也能用 SPIR-V 1.0 工作,但那会迫使我们把 Slang 着色器拆成多个文件,这不禁让人问:那还有什么意义?以 SPIR-V 1.4 为目标,意味着你面对的是能力更强、而非更老旧受限的标准版本。
如果着色器里有语法错误,编译器会像你预期的那样告诉你行号和问题所在。比如可以试着漏掉一个分号,再运行一次编译脚本。也可以试着不带任何参数运行编译器,看看它支持哪些标志。例如,它还能把字节码输出为人类可读的格式,让你确切了解着色器在做什么,以及这一阶段应用了哪些优化。
在命令行上编译着色器是最直接的做法之一,但最好的方式——也是本教程采用的方式——是创建一个 CMake 函数:
function (add_slang_shader_target TARGET)
  cmake_parse_arguments ("SHADER" "" "" "SOURCES" ${ARGN})
  set (SHADERS_DIR ${CMAKE_CURRENT_LIST_DIR}/shaders)
  set (ENTRY_POINTS -entry vertMain -entry fragMain)
  add_custom_command (
          OUTPUT ${SHADERS_DIR}
          COMMAND ${CMAKE_COMMAND} -E make_directory ${SHADERS_DIR}
  )
  add_custom_command (
          OUTPUT  ${SHADERS_DIR}/slang.spv
          COMMAND ${SLANGC_EXECUTABLE} ${SHADER_SOURCES} -target spirv -profile spirv_1_4 -emit-spirv-directly -fvk-use-entrypoint-name ${ENTRY_POINTS} -o slang.spv
          WORKING_DIRECTORY ${SHADERS_DIR}
          DEPENDS ${SHADERS_DIR} ${SHADER_SOURCES}
          COMMENT "Compiling Slang Shaders"
          VERBATIM
  )
  add_custom_target (${TARGET} DEPENDS ${SHADERS_DIR}/slang.spv)
endfunction()
然后就可以像下面这样把 Slang 构建步骤加到你的目标上:
add_slang_shader_target( foo SOURCES ${SHADER_SLANG_SOURCES})
add_dependencies(bar foo)
加载着色器
既然已经有了生成 SPIR-V 着色器的办法,接下来就该把它们加载到程序里,以便在某个环节接入图形管线。我们先写一个简单的辅助函数,从文件中读取二进制数据。
#include <fstream>

...

static std::vector<char> readFile(const std::string& filename) {
    std::ifstream file(filename, std::ios::ate | std::ios::binary);

    if (!file.is_open()) {
        throw std::runtime_error("failed to open file!");
    }
}
readFile 函数会读出指定文件的全部字节,并以 std::vector 管理的字节数组形式返回。我们先用两个标志打开文件:
-
ate:从文件末尾开始读取 -
binary:以二进制方式读取文件(避免文本转换)
从文件末尾开始读的好处是,可以用读取位置确定文件大小,并据此分配缓冲区:
std::vector<char> buffer(file.tellg());之后可以回到文件开头,一次性读出所有字节:
file.seekg(0, std::ios::beg);
file.read(buffer.data(), static_cast<std::streamsize>(buffer.size()));
最后关闭文件并返回字节:
file.close();

return buffer;
现在我们将在 createGraphicsPipeline 中调用这个函数,加载两个着色器的字节码:
void createGraphicsPipeline() {
    auto shaderCode = readFile("shaders/slang.spv");
}
建议打印缓冲区大小,并与实际文件字节数核对,确认着色器加载正确。注意这是二进制代码,不需要以 null 结尾,稍后我们会显式指定其长度。
创建着色器模块
在把代码传给管线之前,必须先把它包装成 vk::raii::ShaderModule 对象。我们来写一个辅助函数 createShaderModule 完成这件事。
[[nodiscard]] vk::raii::ShaderModule createShaderModule(const std::vector<char>& code) const
{
}
这个函数接受存放字节码的缓冲区作为参数,并由它创建 vk::raii::ShaderModule。
创建着色器模块很简单,只需指明字节码缓冲区的指针及其长度。这些信息由 vk::ShaderModuleCreateInfo 结构体给出。唯一需要注意的是,字节码大小以字节为单位,而字节码指针是 uint32_t 指针而不是 char 指针。因此需要用 reinterpret_cast 转换指针,如下所示。做这种转换时,还要确保数据满足 uint32_t 的对齐要求。幸运的是,数据存放在 std::vector 中,其默认分配器已经保证数据满足最坏情况下的对齐要求。
vk::ShaderModuleCreateInfo createInfo{ .codeSize = code.size() * sizeof(char), .pCode = reinterpret_cast<const uint32_t*>(code.data()) };然后就可以通过构造函数创建 vk::raii::ShaderModule:
vk::raii::ShaderModule shaderModule{ device, createInfo };参数与之前那些对象创建函数相同:逻辑设备和创建信息结构体的引用。着色器模块创建完成后,存放代码的缓冲区可以立即释放。别忘了返回创建好的着色器模块:
return shaderModule;着色器模块只是对我们先前从文件加载的着色器字节码及其内部定义函数的一层薄封装。把 SPIR-V 字节码编译并链接成 GPU 可执行的机器码,要等到创建图形管线时才会发生。这意味着管线创建一结束,我们就可以再次销毁着色器模块,因此我们让它们成为 createGraphicsPipeline 函数中的局部变量,而不是类成员:
void createGraphicsPipeline() {
    vk::raii::ShaderModule shaderModule = createShaderModule(readFile("shaders/slang.spv"));
创建着色器阶段
要真正用上这些着色器,需要通过 vk::PipelineShaderStageCreateInfo 结构体把它们分配到具体的管线阶段,作为管线创建过程的一部分。
我们先在 createGraphicsPipeline 函数里填写顶点着色器对应的结构体。
vk::PipelineShaderStageCreateInfo vertShaderStageInfo{ .stage = vk::ShaderStageFlagBits::eVertex, .module = shaderModule, .pName = "vertMain" };第一个参数指定所处的阶段。接下来两个参数分别指定包含代码的着色器模块,以及要调用的函数,即入口点。这意味着可以把多个片元着色器合并到同一个着色器模块里,用不同的入口点区分它们的行为。
还有一个(可选的)成员 pSpecializationInfo,这里不会用到,但值得讨论。它允许你为着色器常量指定取值。这样你就可以只用一个着色器模块,在创建管线时为其中用到的常量指定不同的值,从而配置其行为。这比在渲染时通过变量配置着色器更高效,因为编译器可以做诸如消除依赖这些值的 if 语句之类的优化。如果你没有这类常量,把该成员设为 nullptr 即可,我们的结构体初始化会自动这样做。
改写结构体以适配片元着色器也很简单:
vk::PipelineShaderStageCreateInfo fragShaderStageInfo{ .stage = vk::ShaderStageFlagBits::eFragment, .module = shaderModule, .pName = "fragMain" };最后定义一个数组包含这两个结构体,稍后在实际创建管线时用它来引用两者。
vk::PipelineShaderStageCreateInfo shaderStages[] = {vertShaderStageInfo, fragShaderStageInfo};描述管线可编程阶段的内容就这些。在 下一章,我们会看看固定功能阶段。
C++ 代码 / Slang 着色器 / GLSL 顶点着色器 / GLSL 片元着色器